#@title Estilo de la clase (ejecutar, no hace falta leer) {display-mode: "form"}
from IPython.display import HTML, display
display(HTML(r"""
<style>
@import url('https://fonts.googleapis.com/css2?family=Work+Sans:wght@400;600&family=Amiri:wght@400;700&display=swap');
.rendered_html, .markdown, .cell .text_cell_render { font-family:'Work Sans',system-ui,sans-serif; color:#122535; }
.rendered_html h1,.rendered_html h2,.rendered_html h3 { font-family:'Amiri',Georgia,serif; color:#00529B; }
.rendered_html h2 { border-bottom:2px solid #00529B; padding-bottom:.2em; }
.rendered_html a { color:#00529B; }
.rendered_html table th { background:#00529B; color:#fff; }
.caja { background:#f3f5f7; border-left:4px solid #00529B; padding:.7em 1em; border-radius:4px; }
.ojo { background:#fdf3ec; border-left:4px solid #C8651B; padding:.7em 1em; border-radius:4px; }
</style>
"""))Clase 7 · Series temporales
Analítica de Datos · Maestría en Ciencias del Comportamiento · Universidad de San Andrés
19/09/2026

Hasta ahora, cada fila de nuestras tablas era una persona, y el orden de las filas daba igual. Hoy cada fila es un momento, y el orden es información.
Vamos a trabajar con los tickets de soporte de Nimbus. Nimbus vende una app, y cada vez que un cliente tiene un problema y le escribe al soporte técnico, se abre un ticket: un pedido de ayuda. Hay dos tipos de clientes, empresas (usan la app para trabajar) y particulares (la usan en su tiempo libre). El dataset cuenta cuántos tickets entraron por día durante tres años. Y vamos a hacer tres cosas con esa data:
- Mirarla, y nombrar lo que se ve.
- Desarmarla en tendencia, estacionalidad y resto.
- Pronosticarla, y evaluar si el pronóstico es bueno o es malo.
No hace falta escribir nada: alcanza con correr las celdas de arriba hacia abajo y leer.
Contenido
- La serie: cargar y mirar
- Qué se ve en la serie: tendencia y estacionalidad
- Separar la serie en tres piezas
- El resto: donde aparecen los días en que pasó algo
- Pronosticar, y saber si el pronóstico sirve
- Cierre
Dónde estamos en el programa
| Clase | Tema | Qué de eso usamos hoy |
|---|---|---|
| 4 | Aprendizaje supervisado: separar datos para entrenar y para evaluar | la misma idea, pero con una regla distinta: acá el test son los días más nuevos |
| 5 | Regresión lineal, y el error medio | el MAE, que es con lo que vamos a medir hoy |
| 6 | Clasificación y sus métricas | la idea de comparar contra lo trivial antes de festejar un número |
| 7 | Series temporales | |
| 8 | Árboles y Random Forest |
1. Anatomía de una serie
Los datos se leen por URL. No hay que bajar ni montar nada. Es una tabla con una fecha y tres columnas de tickets.
import os

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

SEED = 42
np.random.seed(SEED)

BASE = "https://raw.githubusercontent.com/tomdamelio/analitica_de_datos_alumnos/main/data/toy-nimbus/"
if os.path.isdir("../../../data/toy-nimbus"):
    BASE = "../../../data/toy-nimbus/"

d = pd.read_csv(BASE + "nimbus_soporte_diario.csv", parse_dates=["fecha"])
d = d.set_index("fecha").asfreq("D")

emp = d["tickets_empresas"]
par = d["tickets_particulares"]
tot = d["tickets"]

print(f"{len(d)} días, de {d.index.min().date()} a {d.index.max().date()}")
d.head()
1096 días, de 2023-01-01 a 2025-12-31| tickets_empresas | tickets_particulares | tickets | feriado | |
|---|---|---|---|---|
| fecha | ||||
| 2023-01-01 | 15 | 214 | 229 | 1 |
| 2023-01-02 | 110 | 63 | 173 | 0 |
| 2023-01-03 | 110 | 77 | 187 | 0 |
| 2023-01-04 | 104 | 55 | 159 | 0 |
| 2023-01-05 | 110 | 68 | 178 | 0 |
Fijate en la estructura: hay un índice, que es una fecha, y columnas de observaciones. Eso es todo lo que hace especial a una serie temporal.
El primer día tiene 15 tickets de empresas y 214 de particulares. Tiene sentido, porque el 1 de enero es feriado, y en 2023 además fue domingo. Es un buen presagio de todo lo que sigue.
Vamos a explorar un poco más la serie de tickets de empresas.
# Estilo de figuras para toda la notebook
plt.rcParams.update({
    "figure.figsize": (11, 3.4),
    "figure.dpi": 110,
    "axes.spines.top": False,
    "axes.spines.right": False,
    "axes.grid": True,
    "grid.alpha": 0.25,
    "font.size": 10,
})
AZUL, NARANJA, GRAFITO, GRIS = "#00529B", "#C8651B", "#3A4A58", "#b9c2ca"


fig, ax = plt.subplots()
ax.plot(emp.index, emp.values, color=GRIS, lw=0.8)
ax.set_title("Tickets de empresas por día · Nimbus · 2023-2025")
ax.set_ylabel("tickets")
plt.show()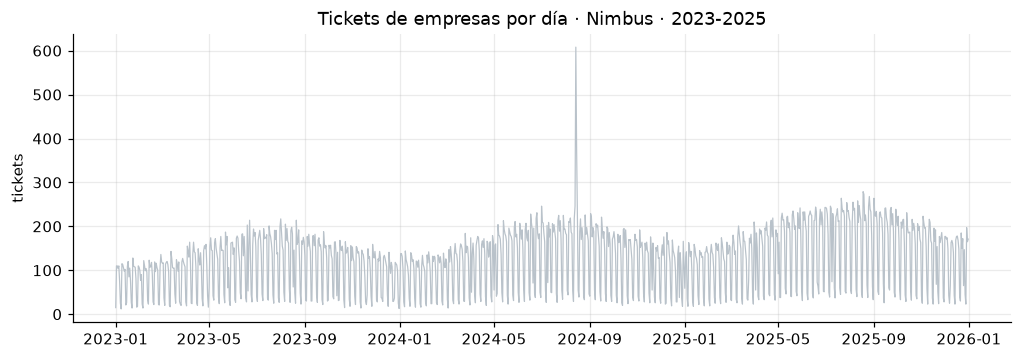
Se ve ruidosa, se ve que sube, y se ve un pico raro en el medio. Vamos a ponerle nombre a cada una de esas tres cosas.
2. Qué se ve en la serie: tendencia y estacionalidad
2.1 La tendencia: la parte que cambia despacio
La tendencia es la parte que se mueve más lento de la serie, lo que cambia despacio.
por_anio = emp.groupby(emp.index.year).mean()
print(por_anio.round(1))

print(f"\nDe {por_anio[2023]:.0f} a {por_anio[2025]:.0f} tickets por día en tres años.")
fecha
2023 106.6
2024 126.0
2025 145.3
Name: tickets_empresas, dtype: float64
De 107 a 145 tickets por día en tres años.2.2 La estacionalidad: lo que se repite con el calendario
La estacionalidad es un cambio regular y periódico, con período fijo y conocido. La estacionalidad para el comportamiento es importantísima, porque normalmente está determinada por convenciones del comportamiento social alrededor de fechas. O sea: es gente haciendo cosas juntas porque se pusieron de acuerdo en cómo dividir el año.
MESES = ["ene", "feb", "mar", "abr", "may", "jun", "jul", "ago", "sep", "oct", "nov", "dic"]
por_mes = emp.groupby(emp.index.month).mean()

fig, ax = plt.subplots(figsize=(9, 3))
colores = [AZUL if m in (1, 8) else GRIS for m in por_mes.index]
ax.bar(MESES, por_mes.values, color=colores)
ax.set_title("Promedio de tickets de empresas, por mes del año")
plt.show()

print(f"enero {por_mes[1]:.0f} · agosto {por_mes[8]:.0f}")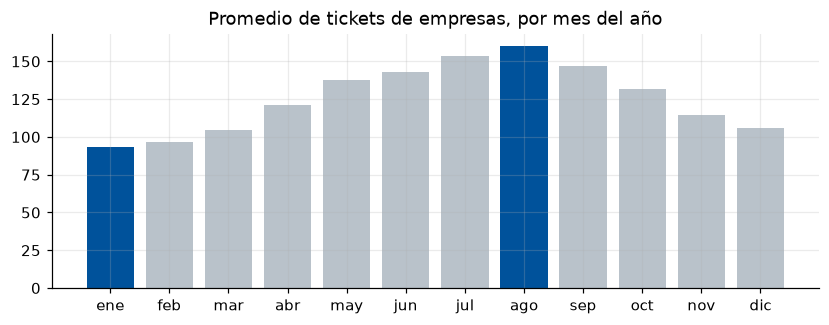
enero 93 · agosto 1602.3 En el total, el día de la semana parece no importar
Ahora cambiamos de serie a propósito. Miramos el total, que es lo que ve cualquiera que abre este archivo por primera vez.
DIAS = ["lun", "mar", "mié", "jue", "vie", "sáb", "dom"]
dow_tot = tot.groupby(tot.index.dayofweek).mean()
swing = (dow_tot.max() - dow_tot.min()) / dow_tot.mean()

fig, ax = plt.subplots(figsize=(8, 3))
ax.bar(DIAS, dow_tot.values, color=GRIS)
ax.set_title("Promedio de tickets TOTALES por día de la semana")
ax.set_ylim(0, dow_tot.max() * 1.25)
plt.show()

print(f"del día más flojo al más cargado: {swing:.1%} de diferencia")
print("conclusión razonable: el día de la semana no importa acá")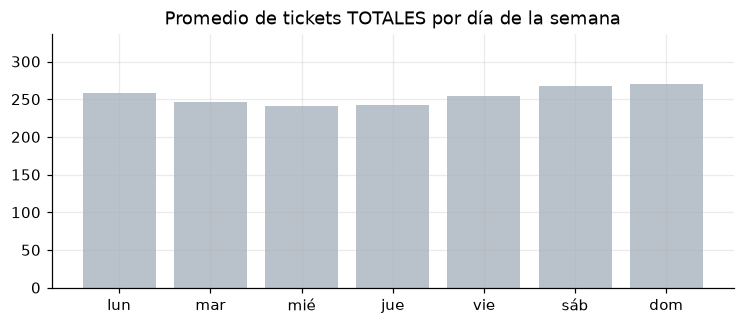
del día más flojo al más cargado: 11.4% de diferencia
conclusión razonable: el día de la semana no importa acá
2.4 Separado por tipo de cliente, el día de la semana importa muchísimo
Pero el total es la suma de dos tipos de cliente: empresas y particulares. Miremos cada uno por separado.
dow_emp = emp.groupby(emp.index.dayofweek).mean()
dow_par = par.groupby(par.index.dayofweek).mean()

ratio_emp = emp[emp.index.dayofweek >= 5].mean() / emp[emp.index.dayofweek < 5].mean()
ratio_par = par[par.index.dayofweek >= 5].mean() / par[par.index.dayofweek < 5].mean()

fig, (a1, a2) = plt.subplots(1, 2, figsize=(11, 3.2), sharey=True)
a1.bar(DIAS, dow_emp.values, color=AZUL)
a1.set_title(f"Empresas · finde = {ratio_emp:.2f}× un día hábil")
a2.bar(DIAS, dow_par.values, color=GRAFITO)
a2.set_title(f"Particulares · finde = {ratio_par:.2f}×")
plt.show()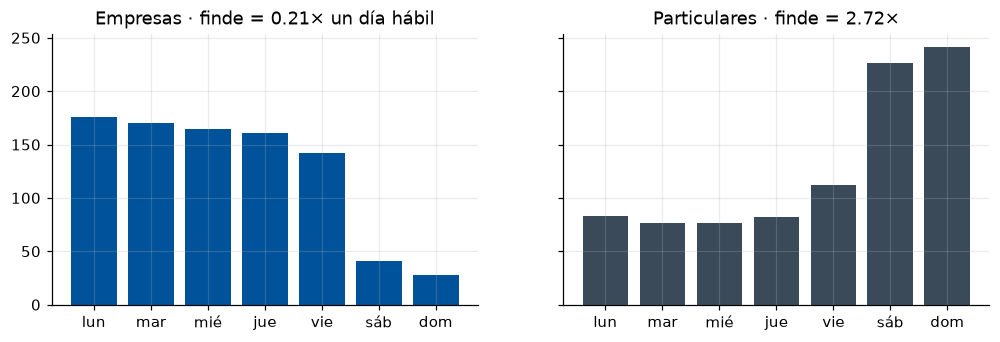
Son espejados: uno baja donde el otro sube. Dos patrones opuestos corriendo al mismo tiempo.
Como los dos ritmos son opuestos y de tamaño parecido, en el total se cancelan. El total parecía no tener patrón semanal, pero en realidad tenía dos.
Agregar (combinar, resumir o promediar conjuntos de datos individuales) por empresas borró el comportamiento. Pasa siempre que juntás poblaciones con conductas distintas en un solo indicador. La pregunta que hay que hacerse es: ¿qué junté para llegar a este número?
fig, axs = plt.subplots(3, 1, figsize=(8, 5), sharex=True, sharey=True)
for ax, (serie, rot, color) in zip(axs, [
    (dow_emp, "Empresas", AZUL),
    (dow_par, "Particulares", GRAFITO),
    (dow_tot, "La suma", GRIS),
]):
    ax.bar(DIAS, serie.values, color=color)
    ax.set_ylabel(rot, rotation=0, ha="right", va="center", fontweight="bold")
axs[0].set_title("Mismo eje, tres series: los dos ritmos se cancelan en la suma")
plt.show()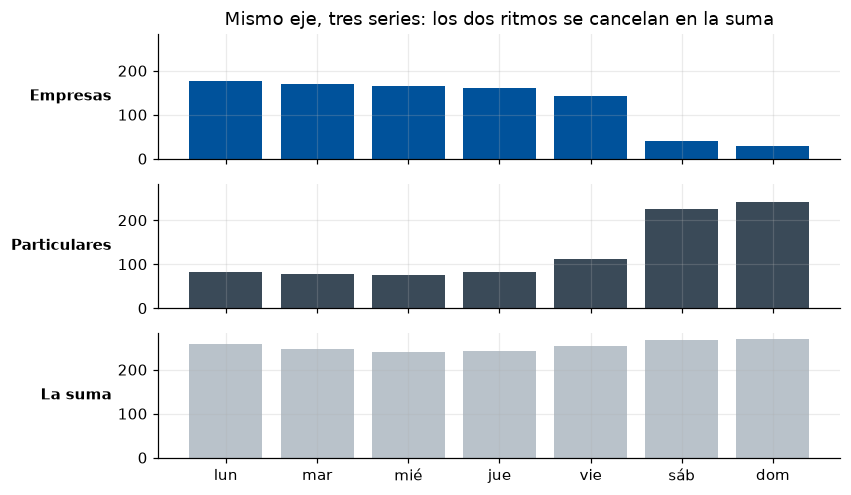
3. Separar la serie en tres piezas
Todo lo que hicimos hasta acá fue mirar la serie y señalar partes: “esto crece”, “enero es el piso”, “el fin de semana cae”. Lo que queremos decir es que lo que vemos cada día sea la suma de tres piezas. En cuentas, esto sería:
\[y = \text{tendencia} + \text{estacionalidad} + \text{resto}\]
donde:
- \(y\) es lo que observamos cada día,
- tendencia es el movimiento lento, de fondo,
- estacionalidad es el patrón que se repite con período fijo,
- resto es todo lo que no es ninguna de las dos.
Esta forma de “representar” o modelar la serie nos permite mirar cosas que nos importan por separado.
3.1 La media móvil: la ventana define qué contás como tendencia
Si la tendencia es lo lento, la forma de verla es borrar lo rápido. La ventana tiene que ser más larga que cualquier período estacional de la serie. Y Nimbus tiene dos: una semanal y una anual.
mm7 = emp.rolling(7, center=True, min_periods=4).mean()
mm365 = emp.rolling(365, center=True, min_periods=183).mean()

fig, ax = plt.subplots()
ax.plot(emp.index, emp.values, color=GRIS, lw=0.6, label="la serie")
ax.plot(mm7.index, mm7.values, color=AZUL, lw=1.6, label="ventana 7 días")
ax.plot(mm365.index, mm365.values, color=NARANJA, lw=2.4, label="ventana 365 días")
ax.legend(loc="upper left", frameon=False, ncols=3)
ax.set_title("La ventana define qué contás como tendencia")
plt.show()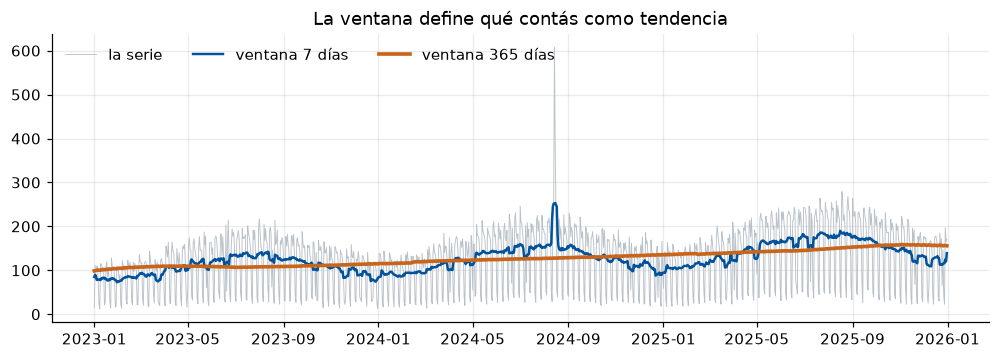
Con ventana de 7 se borra el patrón semanal y queda el ciclo anual adentro de lo que llamamos tendencia. Con 365 se borra también el año. Las dos son correctas: la ventana no descubre la tendencia, la define.
3.2 La descomposición clásica, en cuatro pasos
Son literalmente cuatro líneas. Las hacemos a mano una vez, para que se vea que no hay magia.
# 1. la tendencia, con media móvil de 7 (queremos separar el día de la semana)
tendencia = emp.rolling(7, center=True, min_periods=4).mean()

# 2. restarla
sin_tendencia = emp - tendencia

# 3. promediar por día de la semana: esos siete números SON la estacionalidad
perfil = sin_tendencia.groupby(sin_tendencia.index.dayofweek).mean()
estacionalidad = pd.Series(sin_tendencia.index.dayofweek.map(perfil), index=emp.index)

# 4. el resto es lo que sobra
resto = emp - tendencia - estacionalidad

# la descomposición tiene que reconstruir la serie: es una identidad, no un ajuste
reconstruida = (tendencia + estacionalidad + resto).dropna()
print(np.allclose(reconstruida, emp.loc[reconstruida.index])) # Esto solo muestra True si son iguales

print()
print(perfil.round(1).rename(lambda i: DIAS[i]))
True
fecha
lun 49.6
mar 44.3
mié 38.4
jue 34.8
vie 15.8
sáb -84.9
dom -98.0
Name: tickets_empresas, dtype: float643.3 Dos problemas de sacar la tendencia con una media móvil
Lo que acabamos de hacer en cuatro pasos se llama descomposición clásica. Tiene dos problemas, y cada uno es el motivo por el que existe lo que viene después.
1. No llega hasta el final. Tomemos el último día de la serie, el 31/12/2025. Para calcular su tendencia con una ventana de 7 días hacen falta tres días antes y tres días después: el 1, 2 y 3 de enero de 2026, que todavía no pasaron. Así que el último día se queda sin tendencia. Y el final de la serie es justo desde donde vamos a pronosticar.
2. Un día raro ensucia lo que lo rodea. Un día con un valor muy alto entra en la ventana de todos sus vecinos, así que les infla la tendencia a todos ellos.
# ¿cuánto se pierde en las puntas?
for w in (7, 365):
    faltan = emp.rolling(w, center=True).mean().isna().sum()
    print(f"ventana {w:>3}: {faltan} días sin tendencia ({faltan // 2} de cada lado)")
ventana 7: 6 días sin tendencia (3 de cada lado)
ventana 365: 364 días sin tendencia (182 de cada lado)3.4 STL: la misma descomposición, sin esos dos problemas
STL hace exactamente lo mismo que acabamos de hacer a mano (separar la serie en tendencia, estacionalidad y resto) pero calculando cada pieza con curvas que se ajustan de a tramos en vez de promedios fijos. Eso le permite llegar hasta el último día y no dejarse arrastrar por un día raro.
Con el día raro hace algo sutil que vale la pena mirar: no lo borra. Lo deja entero en el resto, que es donde tiene que estar, pero no lo deja influir en el cálculo de las otras dos piezas.
Nimbus tiene dos ritmos que se repiten: el de la semana (7 días) y el del año (365 días). Los dos son estacionalidad. Así que usamos STL dos veces:
- con
period=7, que separa el ciclo semanal y deja el resto; - con
period=365, sobre la tendencia que salió del paso 1, que la separa en la tendencia de verdad (el crecimiento de la empresa) y la ola anual (enero bajo, agosto alto).
La estacionalidad final es la semanal más la anual.
from statsmodels.tsa.seasonal import STL

# paso 1: el ciclo semanal (en modo robusto, para que el incidente no arrastre nada)
stl = STL(emp.astype(float), period=7, robust=True).fit()

# paso 2: el ciclo anual, sobre la tendencia del paso 1
stl_anual = STL(stl.trend, period=365).fit()

tendencia = stl_anual.trend
estacionalidad = stl.seasonal + stl_anual.seasonal + stl_anual.resid   # semana + año
resto = stl.resid

t0, t1 = tendencia.iloc[0], tendencia.iloc[-1]

fig, axs = plt.subplots(4, 1, figsize=(11, 7), sharex=True)

axs[0].plot(emp.index, emp.values, color=GRIS, lw=0.9)
axs[0].set_ylabel("la serie", rotation=0, ha="right", va="center", fontweight="bold")

axs[1].plot(tendencia.index, tendencia.values, color=AZUL, lw=0.9)
axs[1].set_ylabel("tendencia", rotation=0, ha="right", va="center", fontweight="bold")

axs[2].plot(estacionalidad.index, estacionalidad.values, color=NARANJA, lw=0.9)
axs[2].set_ylabel("estacionalidad", rotation=0, ha="right", va="center", fontweight="bold")

axs[3].plot(resto.index, resto.values, color=GRAFITO, lw=0.9)
axs[3].set_ylabel("resto", rotation=0, ha="right", va="center", fontweight="bold")

axs[0].set_title("STL con dos ciclos sobre los tickets de empresas (7 y 365 días)")
plt.show()

print(f"la tendencia va de {t0:.0f} a {t1:.0f} tickets por día")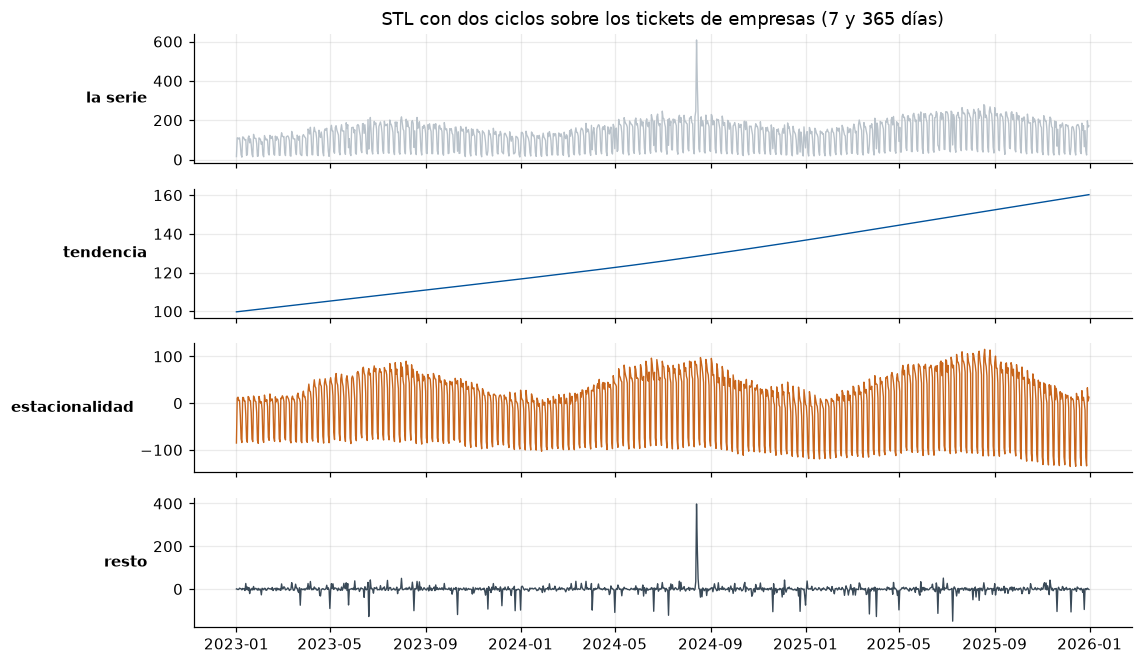
la tendencia va de 100 a 160 tickets por día4. El resto: donde aparecen los días en que pasó algo
El nombre juega en contra. “Resto” suena a sobra. Pero pensá en lo que hacemos cuando extraemos estacionalidad y tendencia. Le estamos sacando a la serie todo lo que se repite. Entonces, si un día quedó grande acá, no es porque la empresa creció ni porque era lunes. Es porque ese día pasó algo. El resto, entonces, puede ser importantísimo.
top = stl.resid.abs().sort_values(ascending=False).head(5)
print("Los cinco días con el resto más grande:")
for f in top.index:
    print(f"  {f.date()}  resto {stl.resid[f]:+7.0f}   feriado={bool(d.loc[f, 'feriado'])}")

incidente = pd.Timestamp("2024-08-14")

fer_habil = (d["feriado"] == 1) & (d.index.dayofweek < 5)
resto_feriados = stl.resid[fer_habil].mean()

print(f"\nEl incidente del 14/08/2024 deja un resto de {stl.resid[incidente]:+.0f}")
print(f"Un feriado en día hábil deja, en promedio, {resto_feriados:+.0f}")
Los cinco días con el resto más grande:
2024-08-14 resto +398 feriado=False
2024-08-15 resto +188 feriado=False
2025-07-09 resto -150 feriado=True
2023-06-20 resto -129 feriado=True
2025-04-02 resto -129 feriado=True
El incidente del 14/08/2024 deja un resto de +398
Un feriado en día hábil deja, en promedio, -104fig, ax = plt.subplots(figsize=(11, 3.6))
ax.axhline(0, color="#cfd5da", lw=1)
ax.plot(stl.resid.index, stl.resid.values, color=GRIS, lw=0.7)
ax.scatter([incidente], [stl.resid[incidente]], color="#B4232E", zorder=3, s=45)
ax.annotate(f"14/08/2024 · {stl.resid[incidente]:+.0f}",
xy=(incidente, stl.resid[incidente]), xytext=(20, -6),
textcoords="offset points", color="#B4232E", fontweight="bold")
ax.scatter(d.index[fer_habil], stl.resid[fer_habil], color=NARANJA, zorder=3, s=18,
label=f"feriados (promedio {resto_feriados:+.0f})")
ax.legend(loc="lower left", frameon=False)
ax.set_title("El resto, con las novedades marcadas encima")
plt.show()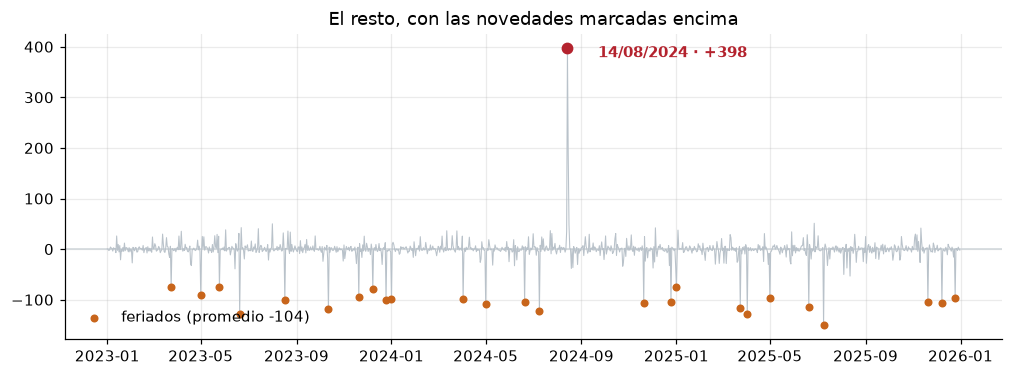
Fijate lo que acabamos de hacer sin querer. Sacamos lo repetitivo, miramos lo que quedaba, le marcamos los feriados encima, y descubrimos que los feriados parecen tener poder predictivo. Esa es una variable nueva que ganamos mirando el resto, y que en el gráfico de la serie original no se veía.
5. Pronosticar, y saber si el pronóstico sirve
Hasta acá miramos la serie. Ahora queremos decir qué va a pasar en los próximos días, y sobre todo saber si lo que decimos es bueno o es malo.
5.1 El test de una serie temporal es la cola
Para saber si un pronóstico sirve hay que probarlo con datos que el método no vio. Como venimos haciendo, hay que separar una parte para entrenar, otra para evaluar.
Con una serie temporal esa partición tiene una sola forma posible: el test son los días más nuevos, los del final. Nunca días salpicados al azar por el medio, porque entonces el método aprendería de días posteriores a los que después tiene que adivinar, y nos daría un número mejor que el real.
El test es la cola de la serie. ¿Y de qué tamaño? Acá hay una diferencia con lo que veníamos haciendo: en las clases 4 a 6 partíamos 70/30. En una serie temporal el tamaño del test no se elige por porcentaje, sino por cuánto querés mirar hacia adelante: si querés pronosticar un mes, evaluá con un mes. El 70/30 servía para tablas donde el orden no importa y cualquier fila podía ser de test; acá lo que manda es el horizonte del pronóstico.
Vamos a entrenar con todo hasta el 30 de septiembre de 2025 y a pronosticar los 31 días de octubre. Eso es menos del 3% de la serie, y está bien: el test dura lo que dura el pronóstico.
CORTE = "2025-09-30"
train, test = emp[:CORTE], emp["2025-10-01":"2025-10-31"]
n_dias = len(test)

print(f"entrenamiento: {train.index.min().date()} a {train.index.max().date()} ({len(train)} días)")
print(f"test:          {test.index.min().date()} a {test.index.max().date()} ({n_dias} días)")
entrenamiento: 2023-01-01 a 2025-09-30 (1004 días)
test: 2025-10-01 a 2025-10-31 (31 días)5.2 Un error no significa nada hasta compararlo con otro
Si te digo que un método se equivoca en 17 tickets por día, ¿es bueno o es malo? No se puede saber. Es la misma pregunta que nos hicimos en la Clase 6 con la precisión de un clasificador. Un número solo no dice nada, hay que ponerlo al lado de algo.
Ese “algo” son métodos tan simples que se escriben en una línea. A esa referencia la vamos a llamar la vara. Usamos tres:
- Media: todos los días futuros valen el promedio de todo lo que pasó.
- Naive (“ingenuo”): mañana va a ser igual a hoy. Todos los días futuros valen el último dato.
- Naive estacional: cada día va a ser igual al mismo día de la semana anterior. El lunes que viene, como el lunes pasado.
Y para comparar usamos el MAE (error absoluto medio): para cada día, la diferencia entre lo que pasó y lo que pronosticamos, sacandole el signo (valor absoluto). Después, tomamos el promedio de eso. La escala está en tickets (acá una unidad de MAE equivale a un ticket), así que se lee directo. Y ojo: acá “error” no quiere decir equivocación, quiere decir la parte que no se podía anticipar.
pron = {
    "media": np.repeat(train.mean(), n_dias),
    "naive": np.repeat(train.iloc[-1], n_dias),
    "naive estacional": np.array([train.iloc[-7 + (i % 7)] for i in range(n_dias)]),
}

def mae(real, pronostico):
    """Error absoluto medio: el promedio de las diferencias, sin signo."""
    return float(np.mean(np.abs(real.values - pronostico)))

# la cuenta a mano, para los tres primeros días de octubre
ne = pron["naive estacional"]
for i in range(3):
    print(f"{test.index[i].date()}: pasó {test.iloc[i]:>3} - pronóstico {ne[i]:>5.0f} - error {abs(test.iloc[i] - ne[i]):>3.0f}")
print(f"promedio de esos tres errores: {np.mean(np.abs(test.values[:3] - ne[:3])):.1f}")

tabla = pd.Series({k: round(mae(test, v), 1) for k, v in pron.items()}, name="MAE")
print("\nMAE de los 31 días de octubre:")
print(tabla)
2025-10-01: pasó 202 - pronóstico 203 - error 1
2025-10-02: pasó 223 - pronóstico 229 - error 6
2025-10-03: pasó 171 - pronóstico 188 - error 17
promedio de esos tres errores: 8.0
MAE de los 31 días de octubre:
media 73.4
naive 64.9
naive estacional 17.3
Name: MAE, dtype: float64fig, ax = plt.subplots()
ctx = emp["2025-08-01":CORTE]
ax.plot(ctx.index, ctx.values, color=GRIS, lw=1, label="entrenamiento")
ax.plot(test.index, test.values, color="#122535", lw=2.2, label="lo que pasó")
for (nombre, v), color in zip(pron.items(), [GRIS, NARANJA, AZUL]):
ax.plot(test.index, v, lw=1.8, color=color, ls="--", label=nombre)
ax.axvline(pd.Timestamp(CORTE), color="#aab3ba", lw=1, ls=":")
ax.legend(loc="upper left", frameon=False, ncols=3, fontsize=8)
ax.set_title("Los tres métodos sobre octubre de 2025")
plt.show()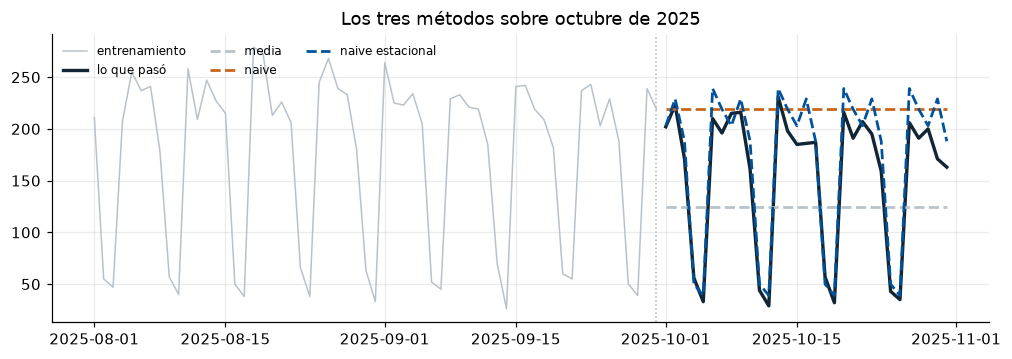
El naive estacional gana por goleada, y lo único que hace es copiar la semana pasada. No aprendió nada: solo sabe lo que nosotros descubrimos en la sección 2, que el día de la semana organiza esta serie.
La conclusión no es “usen naive estacional”. Es que si algún día ajustan un modelo propio, y les da un error de 40 tickets, sin esta tabla al lado van a creer que hicieron un gran trabajo, cuando en realidad copiar la semana pasada da un error de 17.
5.3 No hay un método que gane siempre
Ahora corramos exactamente lo mismo, sin cambiar una coma, sobre la serie total (empresas y particulares sumados).
train_t, test_t = tot[:CORTE], tot["2025-10-01":"2025-10-31"]
pron_t = {
    "media": np.repeat(train_t.mean(), n_dias),
    "naive": np.repeat(train_t.iloc[-1], n_dias),
    "naive estacional": np.array([train_t.iloc[-7 + (i % 7)] for i in range(n_dias)]),
}
tabla_t = pd.Series({k: round(mae(test_t, v), 1) for k, v in pron_t.items()}, name="MAE total")

print(pd.concat([tabla.rename("empresas"), tabla_t.rename("total")], axis=1))
print("\nSobre el total, el naive estacional PIERDE contra el naive simple.")
empresas total
media 73.4 54.6
naive 64.9 14.2
naive estacional 17.3 26.5
Sobre el total, el naive estacional PIERDE contra el naive simple.¿Por qué? Porque el total casi no tiene patrón semanal: los dos canales se cancelan, lo vimos en la sección 2. El naive estacional es el método que apuesta todo a que el día de la semana importa. Cuando importa, gana por goleada. Cuando no, esa apuesta es ruido copiado de la semana pasada.
Gana el método cuya estructura coincide con la estructura de la serie.
Al principio de la clase nos hicimos cinco preguntas. Así quedaron:
| Pregunta | ¿La contestamos? |
|---|---|
| ¿Cuánta gente tengo que contratar para marzo? | Sí: un pronóstico, con 17 tickets de error por día |
| Esto que bajó, ¿bajó de verdad, o baja todos los eneros? | Sí: enero es el piso todos los años (93 contra 160 de agosto) |
| ¿Se nota en los datos el día que se cayó el servicio? | Sí: apareció en el resto, +398 tickets |
| Esto que subió, ¿está creciendo, o son los altibajos de siempre? | Sí: la tendencia va de 78 a 129 |
| ¿Cuándo vamos a dejar de dar abasto? | No: eso es análisis de supervivencia, otro tema |
Para seguir
- Hyndman & Athanasopoulos, Forecasting: Principles and Practice (3ª ed.), otexts.com/fpp3: la lectura obligatoria. Capítulos 2, 3 y 5.
- La versión en Python del mismo libro: otexts.com/fpppy.
- skforecast.org, si alguna vez tienen que pronosticar, acá tienen todas las funciones ya armadas.