#@title Estilo de la clase (ejecutar, no hace falta leer) {display-mode: "form"}
from IPython.display import HTML, display

display(HTML(r"""
<style>
@import url('https://fonts.googleapis.com/css2?family=Work+Sans:wght@400;600&family=Amiri:wght@400;700&display=swap');
.rendered_html, .markdown, .cell .text_cell_render { font-family:'Work Sans',system-ui,sans-serif; color:#122535; }
.rendered_html h1,.rendered_html h2,.rendered_html h3 { font-family:'Amiri',Georgia,serif; color:#00529B; }
.rendered_html h2 { border-bottom:2px solid #00529B; padding-bottom:.2em; }
.rendered_html a { color:#00529B; }
.rendered_html table th { background:#00529B; color:#fff; }
.caja { background:#f3f5f7; border-left:4px solid #00529B; padding:.7em 1em; border-radius:4px; }
.ojo { background:#fdf3ec; border-left:4px solid #C8651B; padding:.7em 1em; border-radius:4px; }
</style>
"""))Clase 8 · Árboles de decisión y Random Forest
Analítica de Datos · Maestría en Ciencias del Comportamiento · Universidad de San Andrés
Primavera 2026 · 26/09/2026

La regresión lineal traza una recta, y la logística también (en otra escala). Hoy vamos a usar un método que separa haciendo preguntas.
Al terminar esta notebook vas a poder:
- entrenar un árbol de decisión y leer su diagrama,
- medir un modelo con validación cruzada en vez de con una sola partición,
- podar un árbol y decir qué hace cada “perilla”,
- correr un random forest y leer su importancia de variables.
Contenido
| # | Tema | La idea en una línea |
|---|---|---|
| 1 | Los datos y el piso | contra qué se compara todo lo que hagamos |
| 2 | Un árbol sin frenarlo | acierta el 100%, y eso es una mala noticia |
| 3 | Medirlo con gente que no vio | con validación cruzada, el número cae |
| 4 | Podar, y leer el árbol | dos perillas, y el árbol pasa a leerse |
| 5 | Random forest | muchos árboles que votan, y qué variables usaron |
| 6 | Cierre | lo que te llevás |
| 7 | Bonus 1: buscar las perillas | busqueda de hiperparámetros con python |
| 8 | Bonus 2: árboles para regresión | modelo listo para correr |
En este notebook hay ejercicios intercalados con explicaciones.
1. Los datos y el piso
Volvemos a los 600 empleados de Nimbus. La columna que queremos predecir es renuncia, y para predecirla tenemos cinco variables: tres de comportamiento (cuántos minutos prende la cámara en la weekly, cuántas weeklys se pierde, cuántas veces falta) y dos de condiciones (cuánto gana y hace cuánto está).
Las tres tablas se leen por URL. salarios tiene una fila por empleado y por año, así que nos quedamos con el último año y unimos las tres tablas por empleado_id, que es la columna que comparten.
import pandas as pd
import matplotlib.pyplot as plt

SEED = 42

# Colores para los gráficos
AZUL = "#00529B"
GRAFITO = "#3A4A58"
GRIS = "#b9c2ca"

BASE = "https://raw.githubusercontent.com/tomdamelio/analitica_de_datos_alumnos/main/data/toy-nimbus/"

rrhh = pd.read_csv(BASE + "nimbus_rrhh.csv")
empleados = pd.read_csv(BASE + "nimbus_empleados.csv")
salarios = pd.read_csv(BASE + "nimbus_salario.csv")

ultimo_anio = salarios["anio"].max()
salario_ultimo = salarios[salarios["anio"] == ultimo_anio]

datos = rrhh.merge(empleados, on="empleado_id")
datos = datos.merge(salario_ultimo, on="empleado_id")

print(datos.shape)
datos.head(3)
(600, 14)| empleado_id | faltas_mes | weeklys_perdidas | minutos_camara_weekly | renuncia | sede | area | genero | educacion_nivel | antiguedad_anios | grupo_fruta | anio | edad | salario_mensual | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | 0 | 45.0 | No | Buenos Aires | Ventas | Masculino | Universitario | 8 | Tratamiento | 2025 | 47 | 1301000.0 |
| 1 | 2 | 1 | 3 | 35.6 | No | Mar del Plata | Ingenieria | Femenino | Posgrado | 8 | Control | 2025 | 46 | 1329000.0 |
| 2 | 3 | 1 | 2 | 31.7 | No | Mendoza | Producto | Femenino | Universitario | 4 | Tratamiento | 2025 | 31 | 1255000.0 |
Ahora armamos las dos piezas que piden los modelos de scikit-learn (recordá que ya los vimos, y las llamamos siempre igual):
X: la tabla con las variables que usamos para predecir.y: la columna que queremos predecir.
y tiene que ser un número o un True / False, nunca el texto "Si" / "No".
# True si renunció, False si no.
datos["renuncio"] = datos["renuncia"] == "Si"

COLUMNAS_FEATURES = [
    "minutos_camara_weekly",
    "weeklys_perdidas",
    "faltas_mes",
    "salario_mensual",
    "antiguedad_anios",
]

X = datos[COLUMNAS_FEATURES]
y = datos["renuncio"]

print(len(datos), "empleados y", len(COLUMNAS_FEATURES), "variables predictoras")
X.head()
600 empleados y 5 variables predictoras| minutos_camara_weekly | weeklys_perdidas | faltas_mes | salario_mensual | antiguedad_anios | |
|---|---|---|---|---|---|
| 0 | 45.0 | 0 | 3 | 1301000.0 | 8 |
| 1 | 35.6 | 3 | 1 | 1329000.0 | 8 |
| 2 | 31.7 | 2 | 1 | 1255000.0 | 4 |
| 3 | 30.4 | 4 | 0 | 1308000.0 | 1 |
| 4 | 45.0 | 4 | 0 | 1471000.0 | 3 |
Antes de entrenar nada, obtenemos el número de cuánto acierta un modelo que no aprende nada. Si sólo el 17% renuncia, entonces la estrategia de decir “no renuncia” para los 600 ya acierta el 83% de las veces. Ese es el piso a superar.
conteo = datos["renuncia"].value_counts()
print(conteo)
print()

piso = conteo["No"] / len(datos)
print(f"piso (decir que nadie renuncia): {piso:.1%}")
renuncia
No 498
Si 102
Name: count, dtype: int64
piso (decir que nadie renuncia): 83.0%2. Un árbol sin frenarlo
Un árbol de decisión elige una variable y un valor, corta en dos basado en eso, y vuelve a hacer lo mismo con las dos cajas que quedaron. El corte que se selecciona en cada paso es el que deja las dos cajas menos mezcladas, y eso se mide con una métrica llamada “impureza de Gini”.
DecisionTreeClassifier de scikit-learn hace toda esa búsqueda. Si no le decimos nada, no se frena nunca, y sigue cortando hasta que cada hoja sea 100% pura.
✏️ Consigna 1
Entrená un árbol sin ponerle ningún límite, con todos los datos, y medí cuánto acierta sobre esos mismos datos.
Pistas:
- el árbol se crea con
DecisionTreeClassifier(random_state=SEED): sin ningún otro argumento, no tiene freno; - se entrena con
.fit(X, y); .score(X, y)devuelve el acierto: la proporción de empleados que clasificó bien.
from sklearn.tree import DecisionTreeClassifier

arbol = DecisionTreeClassifier(random_state=SEED)
# TODO: entrenalo con X e y
arbol.fit(___, ___)

# TODO: medí el acierto sobre esos MISMOS datos
acierto_train = arbol.score(___, ___)
print(f"acierto sobre los mismos datos con los que se entrenó: {acierto_train:.1%}")
Cien por ciento. Ni uno mal.
Recordemos que esto no es un logro!! Es la señal de alarma.
Un modelo de árbol al que no se le pone freno puede hacerle una pregunta a medida a cada empleado hasta que no quede ninguno mezclado. No aprendió nada general de los datos.
Mirá el tamaño del árbol que le hizo falta para lograrlo.
from sklearn.tree import plot_tree

print("hojas del árbol:", arbol.get_n_leaves())
print("profundidad:    ", arbol.get_depth(), "preguntas encadenadas")

plt.figure(figsize=(11, 4))
plot_tree(arbol, filled=True, impurity=False, label="none")
plt.title("El árbol sin podar: ilegible, y ése es el punto")
plt.show()
hojas del árbol: 58
profundidad: 11 preguntas encadenadas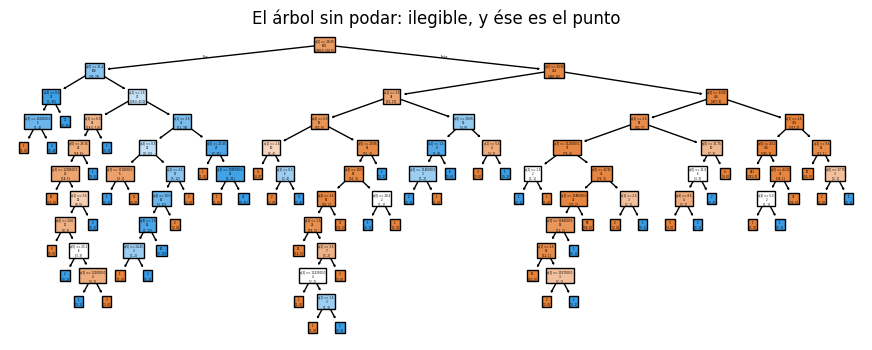
Vamos a medir cuánto le cuesta haber memorizado.
3. Medirlo con gente que no vio
El 100% es en el set de entrenamiento. Lo que importa es cómo le va con empleados que el modelo nunca vio, y en las slides viste por qué no alcanza con apartar un grupo una sola vez: según a quién le toque, el exámen el mismo árbol da 93% o 82%.
La solución es la validación cruzada: se parte en 5 grupos, y cada grupo hace de examen una vez, mientras los otros cuatro sirven para entrenar. Y para que tampoco dependa de cómo cayeron esos cinco grupos, se repite todo 10 veces con repartos distintos y se promedia: 50 exámenes por modelo.
La celda que sigue arma esos repartos una sola vez, en CV. Todos los números de hoy salen de ahí, así que se pueden comparar entre sí.
from sklearn.model_selection import RepeatedStratifiedKFold, cross_val_score

# 5 grupos, repetido 10 veces con repartos distintos.
# "Stratified" quiere decir que cada grupo mantiene el 17% de renuncias.
CV = RepeatedStratifiedKFold(n_splits=5, n_repeats=10, random_state=7)

print(CV.get_n_splits(), "exámenes por modelo")
50 exámenes por modelo✏️ Consigna 2
Medí el árbol sin podar con la validación cruzada, y compará el resultado con el 100% de recién y con el piso.
Pistas:
cross_val_score(modelo, X, y, cv=CV)devuelve un acierto por cada uno de los 50 exámenes;- el modelo se le pasa sin entrenar: la función lo entrena de cero en cada vuelta, sólo con los grupos que no son el examen;
.mean()los promedia.
arbol_sin_entrenar = DecisionTreeClassifier(random_state=SEED)

# TODO: pasale el modelo SIN entrenar, los datos, y los repartos de CV
# n_jobs=-1 le dice que use todos los procesadores, para que tarde menos.
puntajes = cross_val_score(___, X, y, cv=___, n_jobs=-1)
cv_sin_podar = puntajes.mean()
sd_sin_podar = puntajes.std()

print(f"sobre los datos que memorizó: {acierto_train:.1%}")
print(f"con validación cruzada:       {cv_sin_podar:.1%}  (varía ±{sd_sin_podar:.1%})")
print(f"sin modelo (el piso):         {piso:.1%}")
Del 100% al 87,3%. Trece puntos de diferencia cuando le mostramos gente nueva. Y contra el piso, ese árbol de 58 hojas rinde cuatro puntos más que decir “no renuncia” para todo el mundo.
Éste es el sobreajuste u overfitting. El ± es cuánto varía el acierto entre los 50 exámenes. Fijate que la variabilidad entre grupos de testeo no desapareció, pero ahora la vemos y estimamos.
4. Podar, y leer el árbol
El problema del árbol es que creció demasiado. Podarlo es una buena analogía. Se hace con dos perillas, dos hiperparámetros:
max_depth: cuántas preguntas encadenadas puede hacer como máximo.min_samples_leaf: cuántos empleados tiene que quedar como mínimo en cada hoja. Es lo que le impide armar una hoja que solo deje una o dos personas adentro. Pensalo, eso sería sobreajustar a esas dos personas.
✏️ Consigna 3
Entrená un árbol podado con max_depth=4 y min_samples_leaf=10, y evalualo con la misma validación cruzada.
Pistas:
- los dos valores van como argumentos de
DecisionTreeClassifier, junto alrandom_state; - para medirlo es la misma
cross_val_scorede arriba, concv=CV.
# TODO: como máximo 4 preguntas encadenadas, y al menos 10 empleados por hoja
podado = DecisionTreeClassifier(max_depth=___, min_samples_leaf=___, random_state=SEED)

# TODO: medilo con la misma validación cruzada (CV)
puntajes = cross_val_score(podado, X, y, cv=___, n_jobs=-1)
cv_podado = puntajes.mean()
sd_podado = puntajes.std()

print(f"árbol podado: {cv_podado:.1%}  (varía ±{sd_podado:.1%})")

podado.fit(X, y)

print()
print("hojas del árbol sin podar:", arbol.get_n_leaves())
print("hojas del árbol podado:   ", podado.get_n_leaves())
Muchísimas menos hojas, y sin embargo acierta más. El árbol chico acierta más con gente nueva, porque no se ajusto al ruido.
Además, este árbol se puede leer. Para dibujarlo vamos a usar uno de 3 niveles, que entra en la pantalla (con 4 ya cuesta, pero por la calidad gráfica)
para_dibujar = DecisionTreeClassifier(max_depth=3, min_samples_leaf=10, random_state=SEED)
para_dibujar.fit(X, y)

NOMBRES_CORTOS = ["Cámara", "Weeklys perd.", "Faltas", "Salario", "Antigüedad"]

plt.figure(figsize=(13, 5))
plot_tree(para_dibujar, feature_names=NOMBRES_CORTOS, class_names=["se queda", "renuncia"],
          filled=True, impurity=False, rounded=True, fontsize=8)
plt.title("El árbol podado, que sí se puede mostrar en una reunión")
plt.show()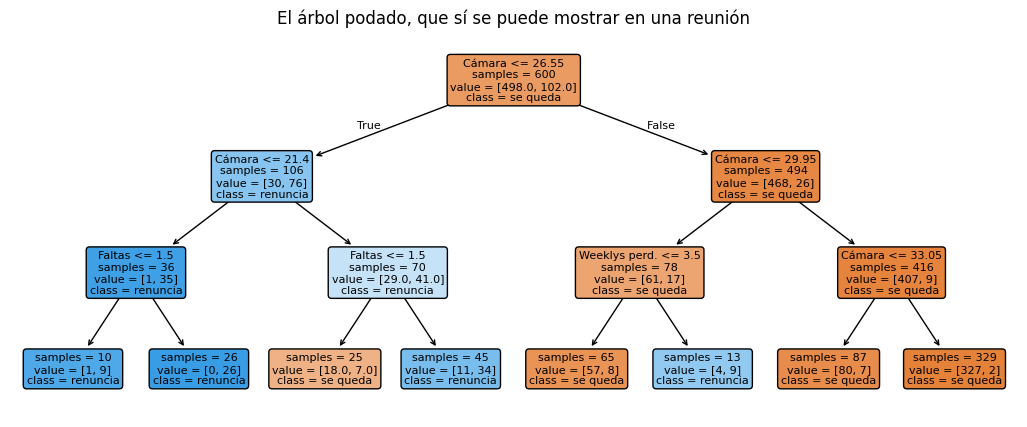
Cómo se lee cada caja:
- arriba está la pregunta (por ejemplo,
Cámara <= 26.55: ¿prende la cámara 26,55 minutos o menos?). Si la respuesta es sí, se sigue por la flecha de la izquierda; si es no, por la de la derecha; sampleses cuánta gente llegó hasta esa caja;valuees cuántos de ellos se quedaron y cuántos renunciaron, en ese orden;classes lo que predice el árbol para cualquiera que termine ahí.
5. Random forest
Un árbol solo es frágil, poco robusto. Es decir, si cambiás un poco los datos, cambia de opinión sobre qué preguntar. La idea de random forest es usar cientos de árboles, y que voten.
Cada árbol se entrena sobre una muestra distinta (sorteada con reposición, lo que se llama bootstrap), y además, en cada corte, sólo puede mirar un subconjunto sorteado de las variables. Eso último es lo que obliga a los árboles a diferenciarse entre sí.
✏️ Consigna 4
Corré un random forest de 300 árboles y evalualo con la misma validación cruzada.
Pistas:
n_estimatorses cuántos árboles;- se mide igual que los árboles, con la misma
cross_val_scorey el mismoCV; - no hace falta tocar nada más: los valores por defecto ya hacen el bootstrap y el sorteo de variables.
from sklearn.ensemble import RandomForestClassifier

# TODO: 300 árboles
bosque = RandomForestClassifier(n_estimators=___, random_state=SEED)

# TODO: la misma validación cruzada que usamos para los árboles
puntajes = cross_val_score(bosque, X, y, cv=___, n_jobs=-1)
cv_bosque = puntajes.mean()
sd_bosque = puntajes.std()

print(f"random forest: {cv_bosque:.1%}  (varía ±{sd_bosque:.1%})")
resumen = pd.DataFrame(
{"acierto": [piso, cv_sin_podar, cv_podado, cv_bosque],
"desvío (±)": [None, sd_sin_podar*100, sd_podado*100, sd_bosque*100]},
index=["sin modelo (el piso)", "árbol sin podar", "árbol podado", "random forest"],
)
resumen.round(3)| acierto | desvío (±) | |
|---|---|---|
| sin modelo (el piso) | 0.830 | NaN |
| árbol sin podar | 0.873 | 2.693 |
| árbol podado | 0.906 | 2.244 |
| random forest | 0.916 | 2.430 |
Un punto por encima del árbol podado.
Dos cosas más. Una: mirá el ±. Dos: el bosque anda bien sin que nadie lo toque. El árbol podado necesitó que eligiéramos dos perillas a mano. El bosque, con los valores por defecto, ya rinde mejor.
¿Y para qué 300 árboles, si mejoramos solo un punto? Porque Nimbus es el caso fácil para un árbol: la renuncia depende de umbrales sueltos sobre dos o tres variables, que es justo la forma que un árbol captura bien. En las slides viste los dos casos donde el bosque sí saca ventaja: una frontera en diagonal (79,9% el árbol contra 87,6% el bosque) y la señal repartida en muchas variables débiles (72,0% contra 86,9%).
Qué variables usó
Fijate que perdimos el diagrama. Ya no hay un árbol para mostrar, hay 300 árboles. Pero la importancia de las variables sobrevive.
¿De dónde sale ese número? Cada vez que el árbol corta, la caja que corta queda más pura, baja la impureza. Esa bajada se pesa por cuánta gente pasó por ese corte: la raíz, por donde pasan todos, pesa entera, mientras que un corte de abajo, por donde quizás pasaron cien personas, pesa mucho menos. Se suman las bajadas de todos los cortes que usaron cada variable, y se divide cada suma por el total para que entre todas den 1. Una variable que el árbol nunca usó para cortar da cero exacto. En un bosque es lo mismo, promediado sobre los 300 árboles.
Todo modelo de árboles la guarda en .feature_importances_, en el mismo orden que las columnas de X.
bosque.fit(X, y)

importancias = pd.DataFrame(
    {"un árbol": para_dibujar.feature_importances_,
     "random forest": bosque.feature_importances_},
    index=NOMBRES_CORTOS,
)
importancias = importancias.sort_values("random forest")

importancias.plot.barh(figsize=(9, 3.5), color=[GRAFITO, AZUL],
                       title="El árbol concentra todo en una variable. El bosque reparte más.")
plt.show()

importancias.round(3)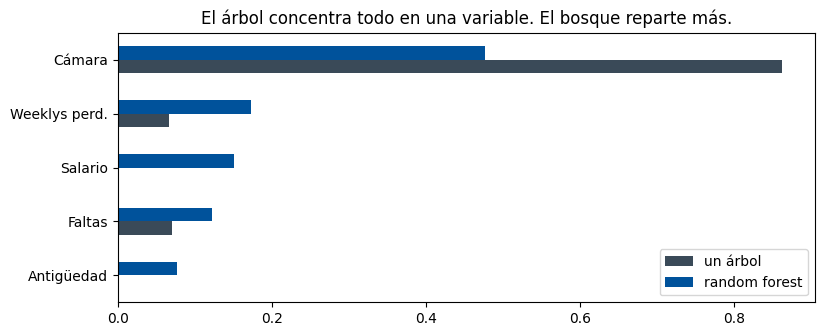
| un árbol | random forest | |
|---|---|---|
| Antigüedad | 0.000 | 0.077 |
| Faltas | 0.071 | 0.122 |
| Salario | 0.000 | 0.151 |
| Weeklys perd. | 0.067 | 0.174 |
| Cámara | 0.862 | 0.477 |
Mirá las dos variables que el árbol dejó en cero exacto. Buscalas en el dibujo del árbol podado, y vas a ver que no aparecen en ninguna caja. Con sólo tres preguntas, siempre tuvo algo mejor a mano. El bosque, en cambio, hace miles de cortes y en cada uno tapa variables al azar, así que todas tienen su oportunidad de mostrar lo que valen.
6. Cierre
Lo que te llevás
- Un árbol pregunta, no traza rayas. Corta una variable en un valor, y vuelve a cortar adentro de lo que quedó. Por eso resuelve cosas que una recta no puede. Al mismo tiempo la interpretabilidad es fácil, porque se puede leer. Cada predicción es un camino.
- Sin podar, memoriza. 100% sobre los datos que ya vio es una señal de alarma, no un logro.
max_depthymin_samples_leafson las dos perillas para frenarlo. - Un modelo se mide con gente que no vio, y con validación cruzada, no con una sola partición.
- Random forest son muchos árboles que votan, y gana donde la señal para predecir está repartida en muchas variables. Se pierde el diagrama, pero se conserva la importancia de variables.
Todo el código de hoy, en cuatro líneas
Sacando los gráficos, medir un modelo bien es esto, y es lo que vas a necesitar para el TP (obviamente, cambiá los parámetros según tus intereses):
modelo = RandomForestClassifier(n_estimators=300, random_state=42)
grupos = RepeatedStratifiedKFold(n_splits=5, n_repeats=10, random_state=7)
puntajes = cross_val_score(modelo, X, y, cv=grupos)
print(puntajes.mean())
Y para comparar modelos es la misma línea con otro modelo adentro: mismos datos, mismos grupos, y el número de cada uno sale comparable.
Para seguir
- El capítulo 8 de James (secciones 1 y 2) es la lectura de esta clase.
- Si te quedaste con ganas:
GradientBoostingClassifieres la otra gran familia de métodos basados en árboles, y no la vimos. Misma idea, pero los árboles se construyen uno corrigiendo al anterior en vez de en paralelo.
7. Bonus: Buscar las perillas
Usa lo mismo que ya corriste (la mismaCV, el mismo árbol), así que si cerraste la notebook, corré primero todas las celdas de arriba.