#@title Estilo de la clase (ejecutar, no hace falta leer) {display-mode: "form"}
from IPython.display import HTML, display

display(HTML(r"""
<style>
@import url('https://fonts.googleapis.com/css2?family=Work+Sans:wght@400;600&family=Amiri:wght@400;700&display=swap');
.rendered_html, .markdown, .cell .text_cell_render { font-family:'Work Sans',system-ui,sans-serif; color:#122535; }
.rendered_html h1,.rendered_html h2,.rendered_html h3 { font-family:'Amiri',Georgia,serif; color:#00529B; }
.rendered_html h2 { border-bottom:2px solid #00529B; padding-bottom:.2em; }
.rendered_html a { color:#00529B; }
.rendered_html table th { background:#00529B; color:#fff; }
.caja { background:#f3f5f7; border-left:4px solid #00529B; padding:.7em 1em; border-radius:4px; }
.ojo { background:#fdf3ec; border-left:4px solid #C8651B; padding:.7em 1em; border-radius:4px; }
</style>
"""))

# Colores de la clase: PC1 en verde y PC2 en violeta, como en las slides.
VERDE = "#31A354"
VIOLETA = "#756BB1"
AZUL = "#00529B"
GRAFITO = "#4A5B6B"Clase 9 · Reducción de dimensionalidad (PCA)
Analítica de Datos · Maestría en Ciencias del Comportamiento · Universidad de San Andrés
Primavera 2026 · 03/10/2026

Hasta la clase pasada siempre había una columna para predecir. Hoy, tenemos once medidas de desempeño de cada empleado de Nimbus y queremos resumirlas en pocas, como se hizo con el Big Five.
Al terminar esta notebook vas a poder:
- encontrar las componentes principales con
PCA, independientemente de la cantidad de variables, - leer loadings, scores y el porcentaje de varianza explicada, y dibujarlos en un scree plot y un biplot,
- armar y usar un
Pipeline(escalar, PCA y logística) para predecir la renuncia, - comparar PCA con un método no lineal (t-SNE o UMAP).
Contenido
| # | Tema | La idea en una línea |
|---|---|---|
| 1 | Once medidas de desempeño | muchas dicen casi lo mismo |
| 2 | PCA con dos medidas | encontrar PC1 y PC2, leer loadings y scores |
| 3 | Las once a la vez | dos componentes con nombre, scree y biplot |
| 4 | Pipeline: escalar, PCA y modelo | un solo objeto que se ajusta y predice |
| 5 | Más allá de lo lineal | t-SNE ve lo que PCA no ve |
| 6 | Cierre | lo que te llevás |
1. Once medidas de desempeño
Recursos humanos de Nimbus junta, para cada uno de los 600 empleados, once medidas de desempeño, y las guardan en nimbus_desempeno.csv. La renuncia está en otra tabla, nimbus_rrhh.csv. La vamos a usar recién en la sección 5, pero la unimos desde ahora, por empleado_id.
import os
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

SEED = 49

BASE = "https://raw.githubusercontent.com/tomdamelio/analitica_de_datos_alumnos/main/data/toy-nimbus/"

desempeno = pd.read_csv(BASE + "nimbus_desempeno.csv")
rrhh = pd.read_csv(BASE + "nimbus_rrhh.csv")

datos = desempeno.merge(rrhh[["empleado_id", "renuncia"]], on="empleado_id")

MEDIDAS = [
    "objetivos_cumplidos_pct",
    "entregas_a_tiempo_pct",
    "tareas_cerradas_mes",
    "horas_foco_semana",
    "evaluacion_lider",
    "okr_score",
    "retrabajos_mes",
    "evaluacion_pares",
    "minutos_mentoria_mes",
    "revisiones_a_otros_mes",
    "iniciativas_internas_anio",
]

X = datos[MEDIDAS]

print(X.shape[0], "empleados y", X.shape[1], "medidas")
X.head()
600 empleados y 11 medidas| objetivos_cumplidos_pct | entregas_a_tiempo_pct | tareas_cerradas_mes | horas_foco_semana | evaluacion_lider | okr_score | retrabajos_mes | evaluacion_pares | minutos_mentoria_mes | revisiones_a_otros_mes | iniciativas_internas_anio | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 63 | 96 | 37 | 22.8 | 4.6 | 0.81 | 1 | 4.1 | 195 | 13 | 1 |
| 1 | 91 | 87 | 35 | 27.1 | 4.3 | 0.77 | 3 | 4.1 | 136 | 13 | 2 |
| 2 | 78 | 89 | 43 | 18.6 | 3.8 | 0.75 | 3 | 2.7 | 25 | 7 | 0 |
| 3 | 65 | 63 | 14 | 13.2 | 2.6 | 0.56 | 4 | 4.2 | 291 | 19 | 2 |
| 4 | 74 | 78 | 36 | 18.1 | 3.3 | 0.63 | 3 | 2.7 | 0 | 2 | 1 |
Mirá el promedio y el desvío de cada medida. Están en unidades muy distintas: porcentajes, conteos por mes, notas de 1 a 5, un puntaje de 0 a 1, minutos. Eso va a importar en la sección 4.
X.describe().round(2)| objetivos_cumplidos_pct | entregas_a_tiempo_pct | tareas_cerradas_mes | horas_foco_semana | evaluacion_lider | okr_score | retrabajos_mes | evaluacion_pares | minutos_mentoria_mes | revisiones_a_otros_mes | iniciativas_internas_anio | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| count | 600.00 | 600.00 | 600.00 | 600.00 | 600.00 | 600.00 | 600.00 | 600.00 | 600.00 | 600.00 | 600.00 |
| mean | 75.63 | 80.08 | 31.93 | 18.22 | 3.52 | 0.66 | 2.99 | 3.73 | 151.05 | 13.81 | 1.99 |
| std | 12.39 | 10.94 | 8.79 | 3.95 | 0.67 | 0.12 | 1.46 | 0.56 | 82.91 | 5.74 | 1.27 |
| min | 21.00 | 20.00 | 1.00 | 8.50 | 1.50 | 0.23 | 0.00 | 1.90 | 0.00 | 0.00 | 0.00 |
| 25% | 68.00 | 74.00 | 26.00 | 15.20 | 3.10 | 0.58 | 2.00 | 3.40 | 89.50 | 10.00 | 1.00 |
| 50% | 78.00 | 83.00 | 32.00 | 18.40 | 3.60 | 0.68 | 3.00 | 3.80 | 150.00 | 14.00 | 2.00 |
| 75% | 85.00 | 88.00 | 38.00 | 21.10 | 4.10 | 0.75 | 4.00 | 4.20 | 208.25 | 18.00 | 3.00 |
| max | 97.00 | 98.00 | 54.00 | 28.50 | 4.80 | 0.93 | 7.00 | 4.90 | 411.00 | 30.00 | 7.00 |
¿Cuánto se repiten entre sí? La matriz de correlaciones muestra, para cada par de medidas, cuánto se mueven juntas: cerca de 1, casi lo mismo; cerca de 0, nada que ver. Con once medidas hay 55 pares distintos, demasiados para mirarlos de a uno en gráficos de dispersión.
correlaciones = X.corr()

fig, ax = plt.subplots(dpi=150)
imagen = ax.imshow(correlaciones, cmap="RdBu_r", vmin=-1, vmax=1)
ax.set_xticks(range(len(MEDIDAS)))
ax.set_yticks(range(len(MEDIDAS)))
ax.set_xticklabels(MEDIDAS, rotation=90, fontsize=8)
ax.set_yticklabels(MEDIDAS, fontsize=8)
fig.colorbar(imagen, ax=ax, shrink=0.8, label="correlación")
ax.set_title("Correlación entre las once medidas")
fig.tight_layout()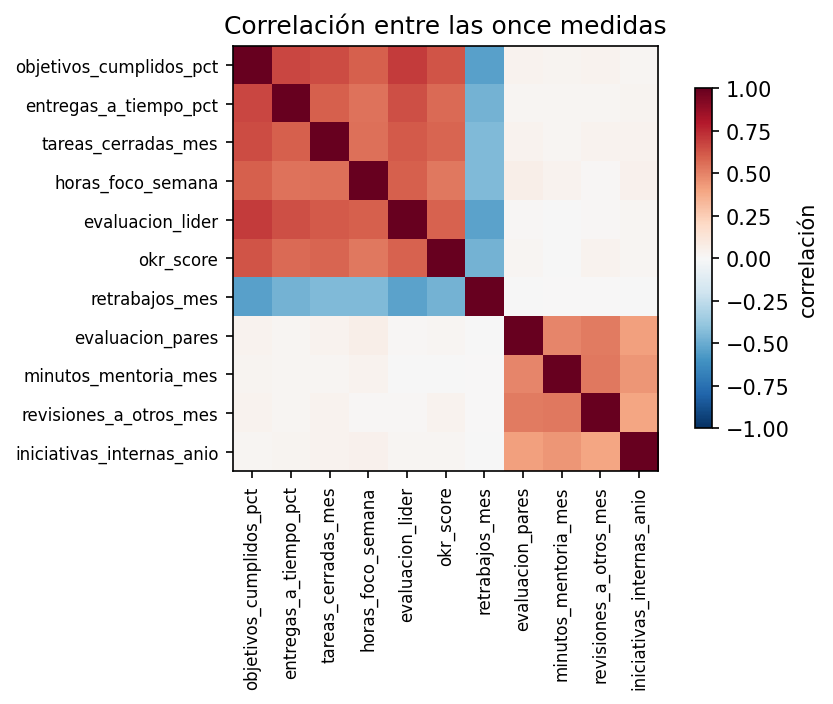
Se ven dos bloques. Las seis primeras medidas (objetivos, entregas, tareas, foco, líder, OKR) correlacionan fuerte entre sí, y retrabajos correlaciona con ellas pero en negativo. Las cuatro últimas (pares, mentoría, revisiones, iniciativas) forman otro bloque. Entre un bloque y el otro, casi nada.
Once columnas, pero parece que hay dos cosas de fondo. PCA es la herramienta para encontrarlas.
2. PCA con dos medidas
Para ver cómo funciona, empezamos con dos medidas: objetivos cumplidos y entregas a tiempo. Antes de PCA las estandarizamos con StandardScaler, que a cada una le resta su promedio y la divide por su desvío, quedando así con promedio en 0 y desvío igual a 1. Recuerden que PCA describe cómo varían los datos alrededor del promedio.
from sklearn.preprocessing import StandardScaler

medidas_par = ["objetivos_cumplidos_pct", "entregas_a_tiempo_pct"]
X_par = StandardScaler().fit_transform(X[medidas_par])
par = pd.DataFrame(X_par, columns=medidas_par)
par.head().round(2)| objetivos_cumplidos_pct | entregas_a_tiempo_pct | |
|---|---|---|
| 0 | -1.02 | 1.46 |
| 1 | 1.24 | 0.63 |
| 2 | 0.19 | 0.82 |
| 3 | -0.86 | -1.56 |
| 4 | -0.13 | -0.19 |
Ahora PCA. Se crea como cualquier modelo, se ajusta con .fit() y se leen dos cosas:
components_: una fila por componente. Cada fila tiene un loading por medida, que indica cuánto pesa esa medida en la componente.explained_variance_ratio_: qué proporción de toda la variación de los datos captura cada componente.
✏️ Consigna 1
Ajustá un PCA con dos componentes sobre las dos medidas y mostrá sus loadings y la proporción de varianza explicada.
Pistas:
PCA(n_components=n)crea el modelo, todavía vacío;.fit()lo ajusta: pasale la tablapar;- después de ajustar, los loadings están en
.components_y la varianza en.explained_variance_ratio_.
from sklearn.decomposition import PCA

# TODO: dos componentes
pca_par = PCA(n_components=___)
# TODO: ajustalo con las dos medidas
pca_par.fit(___)

loadings_par = pd.DataFrame(pca_par.components_, columns=par.columns, index=["PC1", "PC2"])
print(loadings_par.round(3))
print()
print("proporción de varianza explicada:", pca_par.explained_variance_ratio_.round(3))
PC1 pesa parecido en las dos medidas, las dos en positivo. Es la dirección en la que objetivos y entregas crecen juntas. PC2 es la dirección perpendicular, y ahí una sube y la otra baja.
Dos propiedades de los loadings de cada componente:
- al cuadrado suman 1
- el signo es arbitrario: otro programa, por ejemplo R, puede devolver los mismos números con el signo cambiado. Es la misma recta, recorrida al revés. El “peso” de la variable en esa componente es el valor absoluto, el número en sí.
El score de un empleado en PC1 es su nota en esa componente, dónde cae su valor lo proyectamos sobre la recta de PC1. .transform() calcula los scores de todos los empleados, una columna por componente.
scores_par = pd.DataFrame(pca_par.transform(par), columns=["PC1", "PC2"])
scores_par.head(10).round(2)| PC1 | PC2 | |
|---|---|---|
| 0 | 0.31 | 1.75 |
| 1 | 1.33 | -0.43 |
| 2 | 0.71 | 0.44 |
| 3 | -1.71 | -0.50 |
| 4 | -0.23 | -0.04 |
| 5 | -1.05 | -0.52 |
| 6 | 0.80 | -0.04 |
| 7 | -1.54 | 0.36 |
| 8 | 0.68 | -1.08 |
| 9 | -1.53 | -0.43 |
Geométricamente, ¿qué son esos scores? Son un “barrido” que hacemos sobre las direcciones de las componentes que extrajimos con PCA.
from ipywidgets import FloatSlider, interact

fila = 8

centro = pca_par.mean_
pc1 = pca_par.components_[0]
pc2 = pca_par.components_[1]
punto = par.iloc[fila].to_numpy()
score1 = scores_par.loc[fila, "PC1"]
score2 = scores_par.loc[fila, "PC2"]
NARANJA = "#E0823A"
FONDO = {"facecolor": "white", "edgecolor": "none", "alpha": 0.8}


def recta(origen, direccion, largo):
    """Los extremos de un segmento que pasa por `origen`, en la `direccion` dada."""
    extremos = origen + np.outer([-largo, largo], direccion)
    return extremos[:, 0], extremos[:, 1]


def dibujar(sobre_pc1, sobre_pc2):
    fig, ax = plt.subplots(figsize=(7, 6.5), dpi=110)
    ax.scatter(par.iloc[:, 0], par.iloc[:, 1], s=12, color=GRAFITO, alpha=0.15)

    # Los dos ejes nuevos, que se cruzan en el promedio.
    ax.plot(*recta(centro, pc1, 2.5), color=VERDE, linewidth=2.5, label="PC1")
    ax.plot(*recta(centro, pc2, 1.7), color=VIOLETA, linewidth=2.5, label="PC2")
    ax.scatter(*centro, s=60, color="black", zorder=3, label="el promedio")
    ax.scatter(*punto, s=90, color=NARANJA, zorder=5, label=f"empleado de la fila {fila}")

    # "sobre PC1": una recta paralela a PC1 que arranca en el empleado y se corre (en la
    # dirección de PC2) hasta caer sobre PC1. La copia del punto viaja con ella.
    copia1 = punto - sobre_pc1 * score2 * pc2
    ax.plot(*recta(copia1, pc1, 3), color=VERDE, linestyle=":", linewidth=2)
    ax.plot(*zip(punto, copia1), color=NARANJA, linestyle="--", linewidth=1)
    ax.scatter(*copia1, s=110, facecolor="none", edgecolor=NARANJA, linewidth=2, zorder=6)

    # "sobre PC2": lo mismo con una recta paralela a PC2, que se corre hasta caer sobre PC2.
    copia2 = punto - sobre_pc2 * score1 * pc1
    ax.plot(*recta(copia2, pc2, 2), color=VIOLETA, linestyle=":", linewidth=2)
    ax.plot(*zip(punto, copia2), color=NARANJA, linestyle="--", linewidth=1)
    ax.scatter(*copia2, s=110, facecolor="none", edgecolor=NARANJA, linewidth=2, zorder=6)

    # Cuando una copia llega a su PC, ese lugar es la proyección y su posición, el score.
    if sobre_pc1 == 1:
        ax.annotate(f"score en PC1 = {score1:.2f}", xy=copia1, xytext=(12, -20), textcoords="offset points",
                    color=VERDE, fontweight="bold", bbox=FONDO)
    if sobre_pc2 == 1:
        ax.annotate(f"score en PC2 = {score2:.2f}", xy=copia2, xytext=(12, 6), textcoords="offset points",
                    color=VIOLETA, fontweight="bold", bbox=FONDO)

    ax.set_aspect("equal")
    ax.set_xlim(-5.8, 2.6)
    ax.set_ylim(-5.8, 2.6)
    ax.set_xlabel("objetivos cumplidos (estandarizado)")
    ax.set_ylabel("entregas a tiempo (estandarizado)")
    ax.legend(loc="lower right", frameon=False, fontsize=8)
    for lado in ["top", "right"]:
        ax.spines[lado].set_visible(False)
    plt.show()


interact(
    dibujar,
    sobre_pc1=FloatSlider(value=0, min=0, max=1, step=0.05, description="sobre PC1"),
    sobre_pc2=FloatSlider(value=0, min=0, max=1, step=0.05, description="sobre PC2"),
)
dibujar
def dibujar(sobre_pc1, sobre_pc2)
<no docstring>
PC1 es la recta que mejor resume la nube, lo que quiere decir dos cosas:
- es la dirección sobre la que las proyecciones (los scores) quedan más desparramadas;
- la recta que queda más cerca de los puntos, midiendo la distancia en perpendicular.
3. Las once a la vez
La misma receta con las once medidas. Una diferencia: como están en unidades distintas, antes de PCA las estandarizamos con StandardScaler (a cada una le resta su promedio y la divide por su desvío). En la sección 4 vemos qué pasa si no lo hacemos.
✏️ Consigna 2
Estandarizá las once medidas y ajustá un PCA con todas las componentes.
Pistas:
StandardScaler().fit_transform(tus_datos)calcula el promedio y el desvío de cada columna y la estandariza;PCA()sin argumentos se queda con todas las componentes posibles (acá, once);- ajustalo con la tabla estandarizada, no con
X.
from sklearn.preprocessing import StandardScaler

# TODO: estandarizá las once medidas
X_esc = StandardScaler().fit_transform(___)

pca = PCA()
# TODO: ajustá el PCA con la tabla estandarizada
pca.fit(___)

loadings = pd.DataFrame(
    {"PC1": pca.components_[0], "PC2": pca.components_[1]},
    index=MEDIDAS,
)
loadings.round(2).sort_values("PC1", ascending=False)
Leelo columna por columna:
- en PC1 pesan parecido, alrededor de 0,4, las seis medidas de cumplimiento (objetivos, líder, entregas, tareas, OKR, foco), y retrabajos pesa en negativo. Las cuatro de colaboración (mentoría, revisiones, pares, iniciativas) casi no pesan;
- en PC2 es al revés: pesan las cuatro de colaboración y el resto casi nada.
Nadie le dijo al PCA que había dos grupos. Los dos bloques de la matriz de correlaciones aparecen como dos componentes, y el nombre se lo ponemos nosotros. Podemos llamar al PC1 cumplimiento, y al PC2 colaboración. Otra persona podría llamar a PC1 “productividad”. El nombre es una interpretación.
¿Con cuántas componentes nos quedamos? Primero la tabla de varianza explicada, componente por componente y acumulada.
varianza = pd.DataFrame({
    "componente": range(1, len(MEDIDAS) + 1),
    "varianza explicada": pca.explained_variance_ratio_,
    "acumulada": pca.explained_variance_ratio_.cumsum(),
})
varianza.round(3)| componente | varianza explicada | acumulada | |
|---|---|---|---|
| 0 | 1 | 0.404 | 0.404 |
| 1 | 2 | 0.217 | 0.621 |
| 2 | 3 | 0.058 | 0.679 |
| 3 | 4 | 0.055 | 0.733 |
| 4 | 5 | 0.047 | 0.781 |
| 5 | 6 | 0.046 | 0.826 |
| 6 | 7 | 0.041 | 0.867 |
| 7 | 8 | 0.039 | 0.906 |
| 8 | 9 | 0.036 | 0.943 |
| 9 | 10 | 0.031 | 0.974 |
| 10 | 11 | 0.026 | 1.000 |
El scree plot es esa tabla dibujada. Se busca el codo: el punto desde el cual cada componente nueva agrega poco, y se retienen las de antes del codo.
componentes = varianza["componente"]
colores = [VERDE, VIOLETA] + ["#aab4bd"] * (len(MEDIDAS) - 2)

fig, ax = plt.subplots(figsize=(7.5, 4.2), dpi=150)
ax.bar(componentes, varianza["varianza explicada"], color=colores)
ax.plot(componentes, varianza["varianza explicada"], color="#b0572f", marker="o")
ax.axhline(1 / len(MEDIDAS), color=GRAFITO, linestyle="--", linewidth=1, label="Varianza de un PC, si fuera distribuida uniformemente")
ax.set_xticks(componentes)
ax.set_xlabel("Componente")
ax.set_ylabel("Proporción de varianza explicada")
ax.legend(frameon=False)
for lado in ["top", "right"]:
    ax.spines[lado].set_visible(False)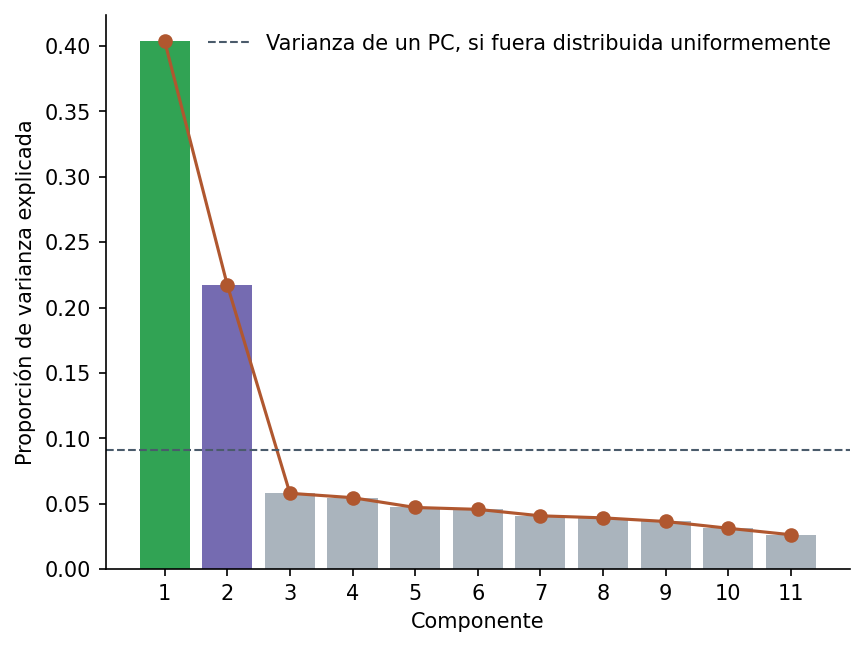
Las dos primeras explican cerca del 62 % entre las dos, y desde la tercera la línea se aplana: el codo está en la 3, así que nos quedamos con dos. El libro lo admite con todas las letras: el codo es un criterio a ojo.
Otra regla muy usada es quedarse con las componentes que explican más que una medida sola (la línea punteada, 1/11). Con datos estandarizados eso equivale a una varianza mayor que 1, que es la regla de Kaiser. Acá también da dos:
print("varianza de cada componente:", pca.explained_variance_.round(2))
print("componentes con varianza mayor que 1:", (pca.explained_variance_ > 1).sum())
varianza de cada componente: [4.45 2.39 0.64 0.6 0.52 0.5 0.45 0.43 0.4 0.34 0.29]
componentes con varianza mayor que 1: 2El biplot junta todo: cada punto es un empleado ubicado según su nota en PC1 y en PC2, y cada flecha es una medida, dibujada con sus dos loadings. Las flechas que apuntan juntas son medidas que se mueven juntas.
scores = pca.transform(X_esc)

fig, ax = plt.subplots(dpi=150)
ax.scatter(scores[:, 0], scores[:, 1], s=10, color=GRAFITO, alpha=0.25)

escala = 10
for medida in MEDIDAS:
    x_flecha = loadings.loc[medida, "PC1"] * escala
    y_flecha = loadings.loc[medida, "PC2"] * escala
    if abs(x_flecha) > abs(y_flecha):
        color = VERDE
    else:
        color = VIOLETA
    ax.annotate("", xy=(x_flecha, y_flecha), xytext=(0, 0), arrowprops={"arrowstyle": "->", "color": color, "linewidth": 2})

ax.text(3.9, 0.5, "cumplimiento\n(6 medidas)", color=VERDE, fontsize=9, fontweight="bold")
ax.text(0.4, 4.9, "colaboración (4 medidas)", color=VIOLETA, fontsize=9, fontweight="bold")
ax.text(-4.6, 0.6, "retrabajos", color=VERDE, fontsize=9, fontweight="bold")

ax.axhline(0, color="#c5ccd3")
ax.axvline(0, color="#c5ccd3")
ax.set_xlim(-7, 7)
ax.set_ylim(-6, 7)
ax.set_xlabel("PC1: cumplimiento")
ax.set_ylabel("PC2: colaboración")
for lado in ["top", "right"]:
    ax.spines[lado].set_visible(False)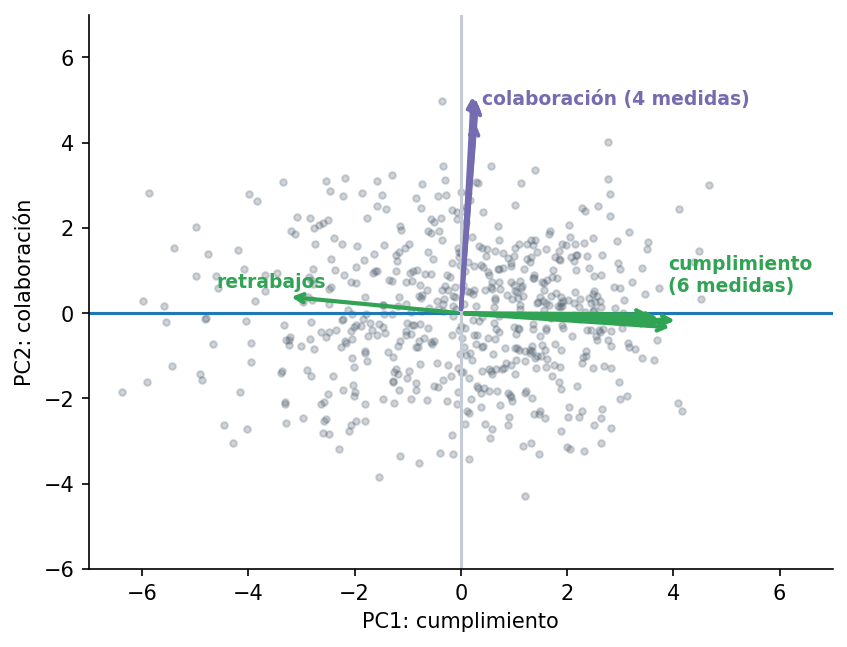
Las seis flechas verdes de cumplimiento se pisan porque apuntan casi igual, y por eso no les pusimos un nombre a cada una: justamente eso queremos ver. Retrabajos apunta al revés, y las cuatro violetas de colaboración van hacia arriba, a 90 grados: no tienen que ver con las otras.
4. Pipeline: escalar, PCA y modelo
PCA no miró la renuncia en ningún momento. Pero ya tenemos una nota de cumplimiento para cada empleado: ¿sirve para predecir quién se va?
datos["renuncio"] = datos["renuncia"] == "Si"
datos["pc1"] = scores[:, 0]

datos.groupby("renuncio")["pc1"].mean().round(2)| pc1 | |
|---|---|
| renuncio | |
| False | 0.45 |
| True | -2.21 |
fig, ax = plt.subplots(dpi=150)
ax.hist(datos.loc[~datos["renuncio"], "pc1"], bins=30, density=True, color=GRAFITO, alpha=0.5, label="Se quedaron")
ax.hist(datos.loc[datos["renuncio"], "pc1"], bins=30, density=True, color="#d6604d", alpha=0.5, label="Renunciaron")
ax.set_xlabel("Score en PC1 (cumplimiento)")
ax.set_ylabel("Proporción")
ax.legend(frameon=False)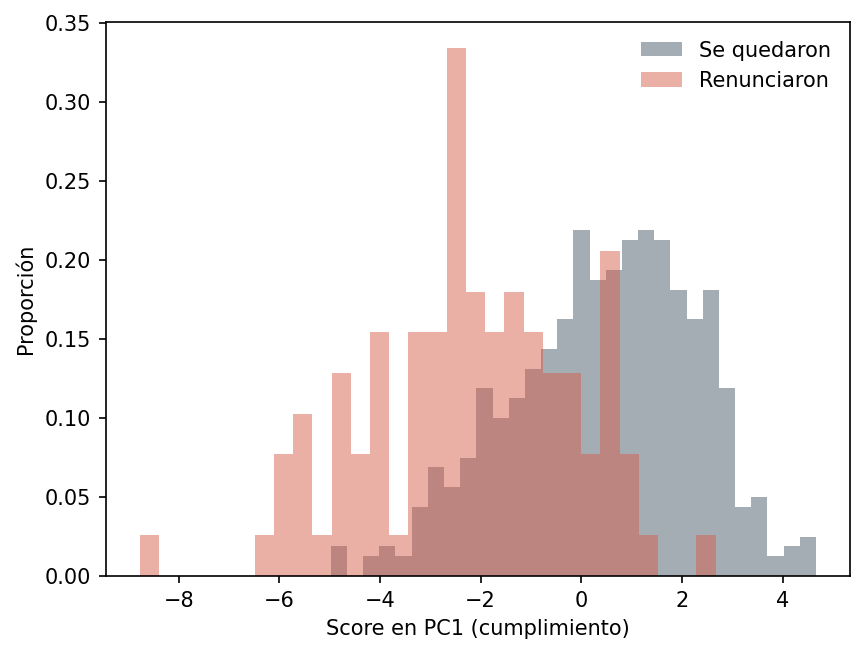
Los que renunciaron tienen, en promedio, menos cumplimiento. Para usar ese score en un modelo hay que encadenar tres pasos: estandarizar, PCA y un modelo de clasificación. Los tres aprenden algo de los datos (el promedio y el desvío de cada medida, los loadings, los coeficientes en una regresión), y los tres tienen que aprenderlo solo con el entrenamiento. Si el promedio o los loadings salen de todos los datos, el testeo ya ayudó a armar el modelo. Eso es lo que llamamos data leakage, o fuga de información.
Scikit-learn cuenta con un objeto Pipeline, que encadena los pasos en uno solo, y se usa como el resto de objetos que vimos:
.fit(X, y)ajusta los pasos en orden, cada uno sobre lo que devuelve el anterior;.predict()y.predict_proba()pasan los datos de prueba (los nuevos) por los mismos pasos, con lo que ya aprendieron, sin volver a ajustar nada.
make_pipeline(paso1, paso2, ...) lo arma: primero lo que prepara los datos, al final el modelo.
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline

y = datos["renuncio"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, stratify=y, random_state=SEED)

modelo = make_pipeline(StandardScaler(), PCA(n_components=1), LogisticRegression(max_iter=2000))
modelo.fit(X_train, y_train)

print(modelo)
Pipeline(steps=[('standardscaler', StandardScaler()),
('pca', PCA(n_components=1)),
('logisticregression', LogisticRegression(max_iter=2000))])Cada paso tiene un nombre: el de su clase, en minúsculas (standardscaler, pca, logisticregression). Con named_steps se mira lo que aprendió cada uno, igual que si lo hubiéramos ajustado suelto.
logistica = modelo.named_steps["logisticregression"]

print("coeficiente de PC1 en la logística:", logistica.coef_[0].round(2))
coeficiente de PC1 en la logística: [-0.74]El signo del coeficiente depende de hacia dónde apunte PC1, que es arbitrario (como vimos antes). Lo que importa es que más “cumplimiento” (el nombre que le pusimos al PC1) va con menos probabilidad de renunciar.
Para usarlo con empleados nuevos alcanza con predict_proba(): el Pipeline los estandariza con el promedio y el desvío del entrenamiento, calcula su nota en PC1 con esos loadings y le aplica la logística. Medimos la AUC en el testeo:
from sklearn.metrics import roc_auc_score

prob_test = modelo.predict_proba(X_test)[:, 1]

print("AUC en el testeo:", roc_auc_score(y_test, prob_test).round(3))
AUC en el testeo: 0.792Una sola partición puede tener mucha suerte (o mala suerte). Como el Pipeline se comporta como un modelo, entra entero en cross_val_score, como en la clase 8, y en cada fold se reajustan los tres pasos solo con el entrenamiento de ese fold. Así comparamos dos modelos de regresión logística:
- con las once medidas, estandarizadas;
- con una sola columna: la nota en PC1;
✏️ Consigna 3
Completá los dos modelos y medí su AUC con la validación cruzada CV.
Pistas:
make_pipeline(paso1, paso2, ...)arma la lista de pasos en orden: primero lo que prepara los datos, al final el modelo;- el de “solo PC1” lleva tres pasos: estandarizar, PCA con una componente y la logística;
cross_val_score(modelo, X, y, cv=CV, scoring="roc_auc")devuelve una AUC por cada fold, y.mean()las promedia.
from sklearn.model_selection import RepeatedStratifiedKFold, cross_val_score

CV = RepeatedStratifiedKFold(n_splits=5, n_repeats=10, random_state=SEED)

modelo_once = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000))
# TODO: estandarizar, quedarse con UNA componente, y la logística
modelo_pc1 = make_pipeline(___, PCA(n_components=___), ___)

auc_once = cross_val_score(modelo_once, X, y, cv=CV, scoring="roc_auc").mean()
# TODO: la misma validación cruzada para el modelo con PC1
auc_pc1 = cross_val_score(___, X, y, cv=___, scoring="roc_auc").mean()

pd.Series(
    [auc_once, auc_pc1],
    index=["las 11 medidas", "solo PC1"],
    name="AUC",
).round(3)
Con una columna la AUC un poquito mejor que con once. Comprimimos once medidas en una sin perder poder predictivo.
Dos cuidados.
- Que PC1 prediga la renuncia es una propiedad de estos datos, no de PCA. PCA busca la dirección de más varianza, y acá coincide con la que baja antes de que alguien decida irse. En otros datos la componente que más varía puede no tener nada que ver con lo que querés predecir, y usar las variables independientemente puede servir más.
- Se pierde interpretabilidad. El coeficiente de PC1 dice “más cumplimiento, menos renuncia”, pero ya no puede decir cuál de las once medidas es la que importa. Si la pregunta es explicativa, eso pesa.
5. Más allá de lo lineal
PCA solo encuentra direcciones rectas. Para ver otros métodos, usamos un dataset clásico de imágenes de dígitos escritos a mano. Cada imagen es una fila de 64 números (“cuánta tinta” hay en cada píxel), así que es una tabla como la de Nimbus, con 64 columnas en lugar de 11.
Comparamos PCA con dos métodos no lineales, t-SNE y UMAP. Los dos intentan que los puntos cercanos en las 64 dimensiones sigan cercanos en el dibujo, en lugar de buscar direcciones rectas. Los 64 píxeles están en la misma unidad, así que acá no se estandariza. Este paso tarda alrededor de un minuto, y la primera vez instala UMAP si no está.
from sklearn.datasets import load_digits
from sklearn.manifold import TSNE
import umap

digitos = load_digits()

en_pca = PCA(n_components=2).fit_transform(digitos.data)
en_tsne = TSNE(n_components=2, perplexity=30, init="pca", random_state=SEED).fit_transform(digitos.data)
en_umap = umap.UMAP(n_components=2, n_neighbors=15, min_dist=0.1, random_state=SEED, n_jobs=1).fit_transform(digitos.data)

fig, ejes = plt.subplots(1, 3, figsize=(15, 5), dpi=150)
for eje, coords, titulo in zip(ejes, [en_pca, en_tsne, en_umap], ["PCA", "t-SNE", "UMAP"]):
    puntos = eje.scatter(coords[:, 0], coords[:, 1], c=digitos.target, cmap="tab10", s=6)
    eje.set_title(titulo)
    eje.set_xticks([])
    eje.set_yticks([])
fig.colorbar(puntos, ax=ejes, ticks=range(10), label="dígito")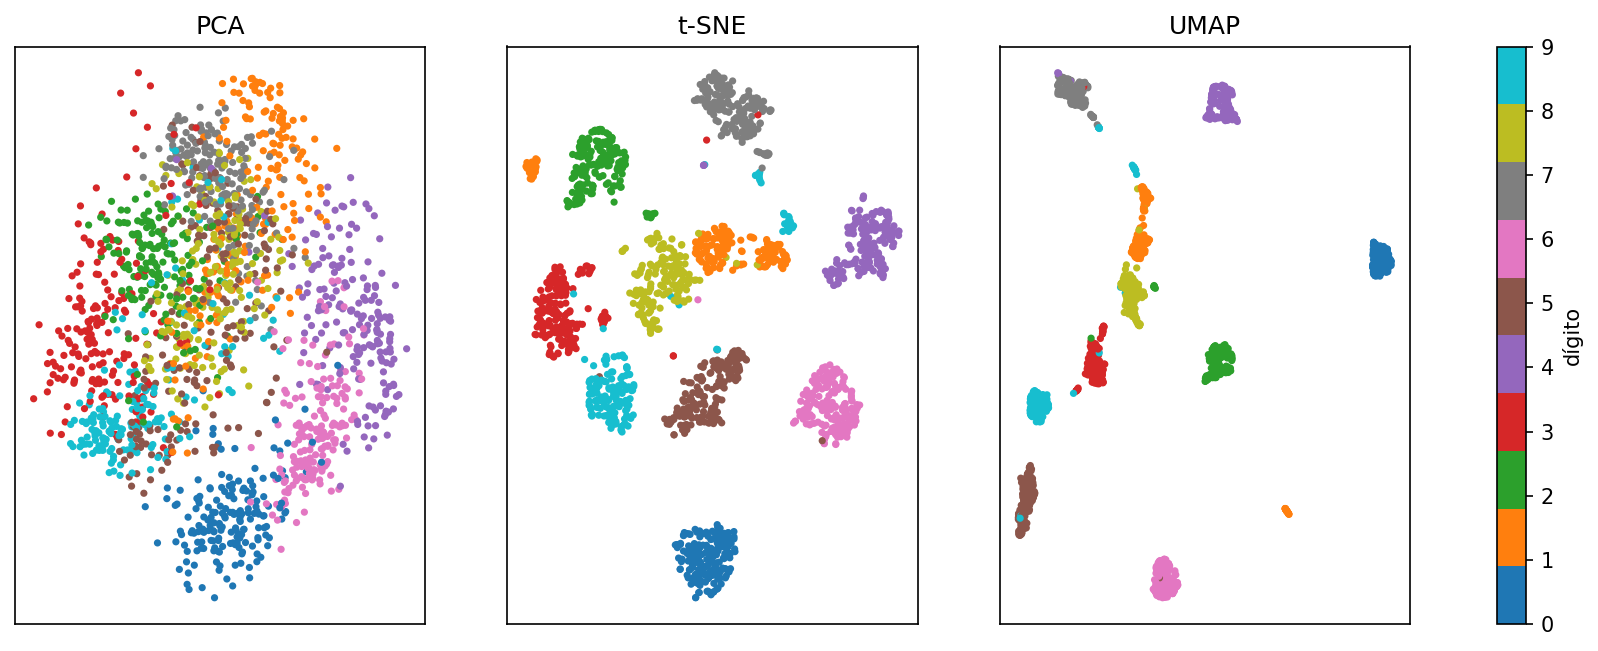
Con PCA los diez dígitos se pisan. Con t-SNE y UMAP aparecen separados. Hay estructura latente, pero no es lineal.
Cada método sirve para cosas distintas:
| PCA | t-SNE | UMAP | |
|---|---|---|---|
| qué busca | direcciones rectas de máxima varianza | que los vecinos sigan siendo vecinos | que los vecinos sigan siendo vecinos, conservando algo más de la forma global |
| se puede leer | parcialmente: perdemos granularidad, pero los loadings dicen qué pesa | no: los ejes no significan nada | no: los ejes no significan nada |
| da siempre lo mismo | sí | no: cambia con la semilla y con perplexity |
no: cambia con la semilla, con n_neighbors y con min_dist |
| se aplica a casos nuevos | sí, con .transform() |
no | sí, con .transform() |
| sirve para | resumir, armar índices, preparar datos para un modelo | mirar si hay grupos | mirar si hay grupos |
En t-SNE tampoco significan nada las distancias entre grupos ni su tamaño. UMAP es una alternativa más rápida que sí se aplica a casos nuevos. Con t-SNE y UMAP se descubre explorando a través de los parámetros, con PCA se mide ya que es algo fijo.
6. Cierre
Lo que te llevás
- Reducir dimensiones es encontrar direcciones. Muchas medidas que se mueven juntas se resumen en pocas componentes; el nombre se lo ponemos nosotros, y a cambio se pierde la lectura directa de cada medida.
- PC1 es la dirección de máxima varianza, que es la misma recta que queda más cerca de los puntos. PC2, la máxima varianza que queda, a 90 grados.
- Loadings, scores y biplot. Los loadings son la receta; el score, la nota de cada caso; el biplot, las dos cosas en un dibujo.
- Cuántas componentes es una decisión. El codo del scree plot y la regla de Kaiser ayudan, pero no deciden solos.
- Escalar antes, salvo que todo esté en la misma unidad.
- El
Pipelineencadena los pasos. Se ajusta con.fit()sobre el entrenamiento y se usa como un modelo: todo lo que aprende de los datos queda adentro. - PCA solo ve rectas. Para mirar estructura no lineal está t-SNE, que sirve para descubrir pero no para medir.
Todo el código de hoy, en pocas líneas
modelo = make_pipeline(StandardScaler(), PCA(n_components=1), LogisticRegression(max_iter=2000))
modelo.fit(X_train, y_train)                                  # los tres pasos, con el entrenamiento
prob = modelo.predict_proba(X_test)[:, 1]                     # los mismos pasos, con casos nuevos
auc = cross_val_score(modelo, X, y, cv=5, scoring="roc_auc")  # el Pipeline entero, adentro de la CV
Para seguir
- James y otros, capítulo 12, secciones 1 y 2, es la lectura de esta clase; la sección 6.3.1 cuenta cómo usar componentes para predecir.
- La clase que viene: clustering. ¿Hay grupos de empleados en el plano de cumplimiento y colaboración?