#@title Estilo de la clase (ejecutar, no hace falta leer) {display-mode: "form"}
IRdisplay::display_html(r"---(
<style>
@import url('https://fonts.googleapis.com/css2?family=Work+Sans:wght@400;600&family=Amiri:wght@400;700&display=swap');
.rendered_html, .markdown, .cell .text_cell_render { font-family:'Work Sans',system-ui,sans-serif; color:#122535; }
.rendered_html h1,.rendered_html h2,.rendered_html h3 { font-family:'Amiri',Georgia,serif; color:#00529B; }
.rendered_html h2 { border-bottom:2px solid #00529B; padding-bottom:.2em; }
.rendered_html a { color:#00529B; }
.rendered_html table th { background:#00529B; color:#fff; }
.caja { background:#f3f5f7; border-left:4px solid #00529B; padding:.7em 1em; border-radius:4px; }
.ojo { background:#fdf3ec; border-left:4px solid #C8651B; padding:.7em 1em; border-radius:4px; }
</style>
)---")Clase 9 · Reducción de dimensionalidad (PCA)
Analítica de Datos · Maestría en Ciencias del Comportamiento · Universidad de San Andrés
Primavera 2026 · 03/10/2026

Hasta la clase pasada siempre había una columna para predecir. Hoy no: tenemos once medidas de desempeño de cada empleado de Nimbus y queremos resumirlas en pocas, como se hizo con el Big Five.
Al terminar esta notebook vas a poder:
- encontrar las componentes principales con
prcomp(), - leer loadings, scores y el porcentaje de varianza explicada,
- decidir cuántas componentes quedarte con un scree plot,
- escalar antes de PCA y explicar por qué,
- usar PCA adentro de la validación cruzada, sin leakage, para predecir la renuncia.
Contenido
| # | Tema | La idea en una línea |
|---|---|---|
| 1 | Once medidas de desempeño | muchas dicen casi lo mismo |
| 2 | PCA con dos medidas | centrar, encontrar PC1, leer loadings y scores |
| 3 | Las once a la vez | dos componentes con nombre, scree y biplot |
| 4 | ¿Y si no escalamos? | gana la medida con la unidad más grande |
| 5 | PC1 y la renuncia | una columna predice como once |
| 6 | Leakage: el experimento del ruido | preprocesar con todos los datos engaña |
| 7 | ¿Cuántas componentes? | si el fin es predecir, lo decide la validación cruzada |
| 8 | Más allá de lo lineal | t-SNE ve lo que PCA no ve |
| 9 | Ejercicio de cierre: la encuesta de clima | sin redundancia, PCA no comprime |
| 10 | Cierre | lo que te llevás |
1. Once medidas de desempeño
Recursos humanos de Nimbus junta, para cada uno de los 600 empleados, once medidas de desempeño que salen de sistemas distintos: el tablero de objetivos, el gestor de tareas, la evaluación del líder, la de los compañeros. Están en nimbus_desempeno.csv. La renuncia está en otra tabla, nimbus_rrhh.csv; la vamos a usar recién en la sección 5, pero la unimos desde ahora por empleado_id.
Nimbus es una empresa simulada para esta materia: los datos se generaron con una estructura conocida, así que al final podemos chequear si PCA la encuentra.
La primera celda instala los dos paquetes que Colab no trae (glmnet y Rtsne); si ya están, no hace nada.
if (!requireNamespace("glmnet", quietly = TRUE)) install.packages("glmnet")
if (!requireNamespace("Rtsne", quietly = TRUE)) install.packages("Rtsne")

library(ggplot2)

SEED <- 49

# Colores de la clase: PC1 en verde y PC2 en violeta, como en las slides.
VERDE <- "#31A354"
VIOLETA <- "#756BB1"
AZUL <- "#00529B"
GRAFITO <- "#4A5B6B"

# Carpeta de figuras de la página de la clase. En Colab no existe, y la figura no se guarda.
CARPETA_FIGURAS <- "../assets/figures"

BASE <- "https://raw.githubusercontent.com/tomdamelio/analitica_de_datos_alumnos/main/data/toy-nimbus/"

desempeno <- read.csv(paste0(BASE, "nimbus_desempeno.csv"))
rrhh <- read.csv(paste0(BASE, "nimbus_rrhh.csv"))

datos <- merge(desempeno, rrhh[, c("empleado_id", "renuncia")], by = "empleado_id")

MEDIDAS <- c(
  "objetivos_cumplidos_pct",
  "entregas_a_tiempo_pct",
  "tareas_cerradas_mes",
  "horas_foco_semana",
  "evaluacion_lider",
  "okr_score",
  "retrabajos_mes",
  "evaluacion_pares",
  "minutos_mentoria_mes",
  "revisiones_a_otros_mes",
  "iniciativas_internas_anio"
)

X <- datos[, MEDIDAS]

cat(nrow(X), "empleados y", ncol(X), "medidas\n")
head(X)
600 empleados y 11 medidas| objetivos_cumplidos_pct | entregas_a_tiempo_pct | tareas_cerradas_mes | horas_foco_semana | evaluacion_lider | okr_score | retrabajos_mes | evaluacion_pares | minutos_mentoria_mes | revisiones_a_otros_mes | iniciativas_internas_anio | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| <int> | <int> | <int> | <dbl> | <dbl> | <dbl> | <int> | <dbl> | <int> | <int> | <int> | |
| 1 | 63 | 96 | 37 | 22.8 | 4.6 | 0.81 | 1 | 4.1 | 195 | 13 | 1 |
| 2 | 91 | 87 | 35 | 27.1 | 4.3 | 0.77 | 3 | 4.1 | 136 | 13 | 2 |
| 3 | 78 | 89 | 43 | 18.6 | 3.8 | 0.75 | 3 | 2.7 | 25 | 7 | 0 |
| 4 | 65 | 63 | 14 | 13.2 | 2.6 | 0.56 | 4 | 4.2 | 291 | 19 | 2 |
| 5 | 74 | 78 | 36 | 18.1 | 3.3 | 0.63 | 3 | 2.7 | 0 | 2 | 1 |
| 6 | 71 | 68 | 21 | 19.7 | 3.4 | 0.69 | 2 | 4.3 | 228 | 23 | 3 |
Mirá el promedio y el desvío de cada medida. Están en unidades muy distintas: porcentajes, conteos por mes, notas de 1 a 5, un puntaje de 0 a 1, minutos. Eso va a importar en la sección 4.
resumen <- data.frame(
  promedio = colMeans(X),
  desvio = apply(X, 2, sd),
  minimo = apply(X, 2, min),
  maximo = apply(X, 2, max)
)
round(resumen, 2)| promedio | desvio | minimo | maximo | |
|---|---|---|---|---|
| <dbl> | <dbl> | <dbl> | <dbl> | |
| objetivos_cumplidos_pct | 75.63 | 12.39 | 21.00 | 97.00 |
| entregas_a_tiempo_pct | 80.08 | 10.94 | 20.00 | 98.00 |
| tareas_cerradas_mes | 31.93 | 8.79 | 1.00 | 54.00 |
| horas_foco_semana | 18.22 | 3.95 | 8.50 | 28.50 |
| evaluacion_lider | 3.52 | 0.67 | 1.50 | 4.80 |
| okr_score | 0.66 | 0.12 | 0.23 | 0.93 |
| retrabajos_mes | 2.99 | 1.46 | 0.00 | 7.00 |
| evaluacion_pares | 3.73 | 0.56 | 1.90 | 4.90 |
| minutos_mentoria_mes | 151.05 | 82.91 | 0.00 | 411.00 |
| revisiones_a_otros_mes | 13.81 | 5.74 | 0.00 | 30.00 |
| iniciativas_internas_anio | 1.99 | 1.27 | 0.00 | 7.00 |
¿Cuánto se repiten entre sí? La matriz de correlaciones muestra, para cada par de medidas, cuánto se mueven juntas: cerca de 1, casi lo mismo; cerca de 0, nada que ver. Con once medidas hay 55 pares distintos, demasiados para mirarlos de a uno en gráficos de dispersión.
ggplot dibuja tablas largas, con una fila por par de medidas; as.data.frame(as.table(...)) convierte la matriz en esa tabla.
correlaciones <- cor(X)

pares <- as.data.frame(as.table(correlaciones))
names(pares) <- c("medida_1", "medida_2", "correlacion")
pares$medida_1 <- factor(pares$medida_1, levels = MEDIDAS)
pares$medida_2 <- factor(pares$medida_2, levels = rev(MEDIDAS))

options(repr.plot.width = 8, repr.plot.height = 7)
figura <- ggplot(pares, aes(medida_1, medida_2, fill = correlacion)) +
  geom_tile() +
  scale_fill_distiller(palette = "RdBu", limits = c(-1, 1), name = "correlación") +
  labs(x = NULL, y = NULL, title = "Correlación entre las once medidas") +
  coord_equal() +
  theme_minimal(base_size = 11) +
  theme(axis.text.x = element_text(angle = 90, hjust = 1, vjust = 0.5))

if (dir.exists(CARPETA_FIGURAS)) {
  ggsave(file.path(CARPETA_FIGURAS, "clase09_correlaciones_r.png"), figura, width = 8, height = 7, dpi = 150)
}
figura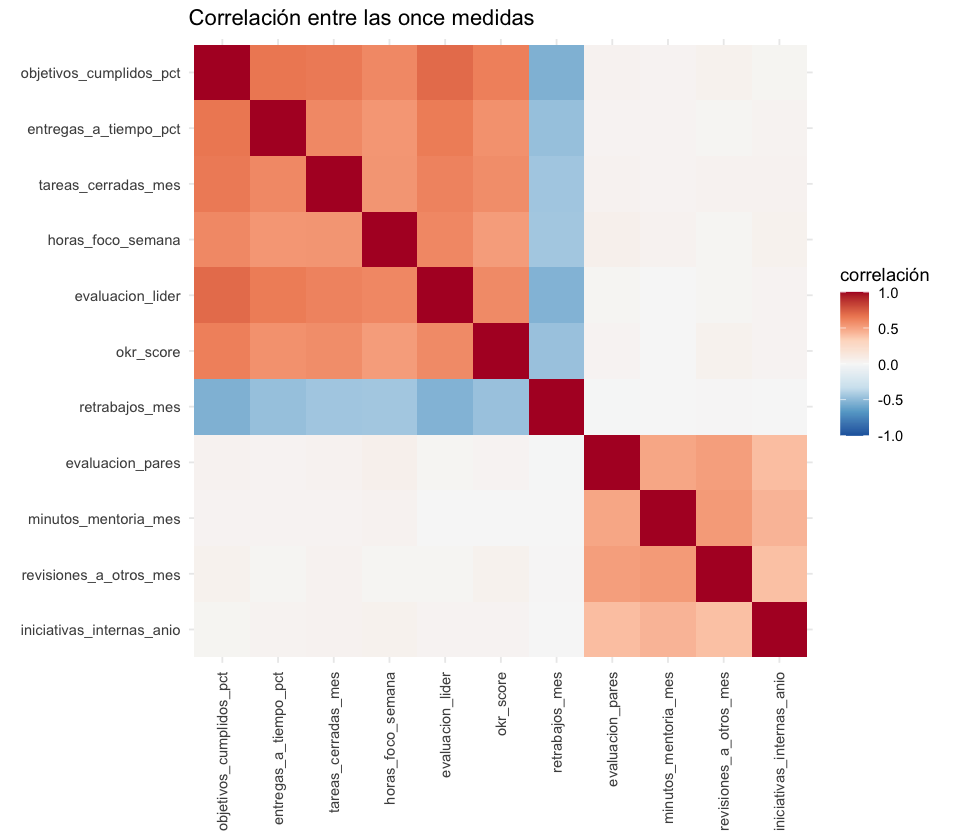
Se ven dos bloques. Las seis primeras medidas (objetivos, entregas, tareas, foco, líder, OKR) correlacionan fuerte entre sí, y retrabajos correlaciona con ellas pero en negativo. Las cuatro últimas (pares, mentoría, revisiones, iniciativas) forman otro bloque. Entre un bloque y el otro, casi nada.
Once columnas, pero parece que hay dos cosas de fondo. PCA es la herramienta para encontrarlas sin mirar el gráfico a ojo.
2. PCA con dos medidas
Para ver cómo funciona por dentro, empezamos con dos medidas: objetivos cumplidos y entregas a tiempo. Las dos están en porcentaje y con desvíos parecidos, así que por ahora alcanza con centrar: restarle a cada medida su promedio. PCA describe cómo varían los datos alrededor del promedio; después de centrar, el promedio de cada columna queda en cero.
scale(par, center = TRUE, scale = FALSE) resta el promedio de cada columna y no divide por nada.
par <- X[, c("objetivos_cumplidos_pct", "entregas_a_tiempo_pct")]

centrado <- scale(par, center = TRUE, scale = FALSE)

cat("promedios originales:\n")
print(round(colMeans(par), 2))
cat("\npromedios después de centrar:\n")
print(round(colMeans(centrado), 10))
promedios originales:
objetivos_cumplidos_pct entregas_a_tiempo_pct
75.63 80.08
promedios después de centrar:
objetivos_cumplidos_pct entregas_a_tiempo_pct
0 0 Ahora el PCA. En R es prcomp(), y del resultado se leen tres cosas:
$rotation: una columna por componente. Cada columna tiene un loading por medida: cuánto pesa esa medida en la componente.$sdev: el desvío de cada componente; al cuadrado, su varianza.$x: los scores, la nota de cada empleado en cada componente.
summary() sobre el resultado muestra la proporción de varianza que captura cada componente.
✏️ Consigna 1
Ajustá un PCA sobre los datos centrados y mostrá sus loadings y la proporción de varianza explicada.
Pistas:
prcomp()recibe la tabla y devuelve todo el PCA de una vez;- pasale
centrado, no la tabla original; - los loadings están en
$rotation, y la proporción de varianza en la fila"Proportion of Variance"desummary(...)$importance.
# TODO: el PCA de los datos centrados
pca_par <- prcomp(___)

print(round(pca_par$rotation, 3))
cat("\nproporción de varianza explicada:", round(summary(pca_par)$importance["Proportion of Variance", ], 3), "\n")
PC1 pesa parecido en las dos medidas, las dos en positivo: es la dirección en la que objetivos y entregas crecen juntas. Captura más del 80 % de la variación de las dos. PC2 es la dirección perpendicular: una sube y la otra baja.
Dos propiedades de los loadings de cada componente:
- al cuadrado suman 1; si no, PCA podría inflar los pesos y la varianza crecería sin límite;
- el signo es arbitrario: otro programa, o la notebook de Python, puede devolver los mismos números con el signo cambiado. Es la misma recta, recorrida al revés.
Lo verificamos, y de paso calculamos el ángulo de PC1 respecto del eje de objetivos.
phi <- pca_par$rotation[, "PC1"]

cat("loadings de PC1:", round(phi, 3), "\n")
cat("suma de sus cuadrados:", round(phi[1]^2 + phi[2]^2, 6), "\n")

angulo <- atan2(phi[2], phi[1]) * 180 / pi
cat("ángulo de PC1:", round(angulo, 1), "grados\n")
loadings de PC1: 0.769 0.639
suma de sus cuadrados: 1
ángulo de PC1: 39.7 gradosEl score de un empleado en PC1 es su nota en esa componente: sus desvíos del promedio, multiplicados por los loadings y sumados. Es exactamente dónde cae su proyección sobre la recta de PC1.
✏️ Consigna 2
Calculá a mano el score en PC1 del empleado de la fila 14 y comparalo con el que calculó prcomp().
Pistas:
- el score es cada desvío del promedio multiplicado por su loading, y todo sumado;
- los loadings de PC1 están en
phi(phi[1]es el de objetivos,phi[2]el de entregas); - los desvíos del empleado están en
desvio(desvio[1]ydesvio[2], en el mismo orden).
fila <- 14
desvio <- centrado[fila, ]

cat("valores del empleado:", unlist(par[fila, ]), "\n")
cat("desvíos del promedio:", round(desvio, 1), "\n")

# TODO: cada desvío por su loading, y sumados
score_a_mano <- phi[1] * ___ + phi[2] * ___
score_prcomp <- pca_par$x[fila, "PC1"]

cat("\nscore en PC1 calculado a mano:", round(score_a_mano, 2), "\n")
cat("score en PC1 según prcomp:    ", round(score_prcomp, 2), "\n")
Cuánta varianza hay sobre cada dirección es $sdev al cuadrado (el software lo llama autovalor). Dividido por la varianza total de las dos medidas, da el porcentaje de varianza explicada. Lo comprobamos por los dos caminos.
varianza_pcs <- pca_par$sdev^2
varianza_total <- var(centrado[, 1]) + var(centrado[, 2])

cat("varianza sobre PC1 y PC2:", round(varianza_pcs, 1), "\n")
cat("varianza total de las dos medidas:", round(varianza_total, 1), "\n\n")
cat("PC1, a mano:       ", round(varianza_pcs[1] / varianza_total, 4), "\n")
cat("PC1, según summary:", round(summary(pca_par)$importance["Proportion of Variance", "PC1"], 4), "\n")
varianza sobre PC1 y PC2: 228.3 45
varianza total de las dos medidas: 273.2
PC1, a mano: 0.8354
PC1, según summary: 0.8354 El dibujo de todo esto: la nube centrada, PC1 en verde (la dirección de máxima varianza) y PC2 en violeta, perpendicular. El punto naranja es el empleado de recién; el verde, su proyección sobre PC1.
phi2 <- pca_par$rotation[, "PC2"]
nube <- data.frame(x = centrado[, 1], y = centrado[, 2])

options(repr.plot.width = 6.5, repr.plot.height = 6)
figura <- ggplot(nube, aes(x, y)) +
  geom_hline(yintercept = 0, colour = "#c5ccd3") +
  geom_vline(xintercept = 0, colour = "#c5ccd3") +
  geom_point(colour = GRAFITO, alpha = 0.3, size = 1.2) +
  annotate("segment", x = -40 * phi[1], y = -40 * phi[2], xend = 40 * phi[1], yend = 40 * phi[2], colour = VERDE, linewidth = 1.3) +
  annotate("segment", x = -20 * phi2[1], y = -20 * phi2[2], xend = 20 * phi2[1], yend = 20 * phi2[2], colour = VIOLETA, linewidth = 1.3) +
  annotate("segment", x = desvio[1], y = desvio[2], xend = score_a_mano * phi[1], yend = score_a_mano * phi[2], colour = "#E0823A", linetype = "dashed") +
  annotate("point", x = desvio[1], y = desvio[2], colour = "#E0823A", size = 4) +
  annotate("point", x = score_a_mano * phi[1], y = score_a_mano * phi[2], colour = VERDE, size = 3.5) +
  annotate("text", x = 26, y = 25, label = "PC1", colour = VERDE, fontface = "bold") +
  annotate("text", x = -15, y = 19, label = "PC2", colour = VIOLETA, fontface = "bold") +
  coord_equal(xlim = c(-46, 30), ylim = c(-46, 30)) +
  labs(x = "objetivos cumplidos (desvío del promedio)", y = "entregas a tiempo (desvío del promedio)") +
  theme_minimal(base_size = 12)

if (dir.exists(CARPETA_FIGURAS)) {
  ggsave(file.path(CARPETA_FIGURAS, "clase09_pca2d_r.png"), figura, width = 6.5, height = 6, dpi = 150)
}
figura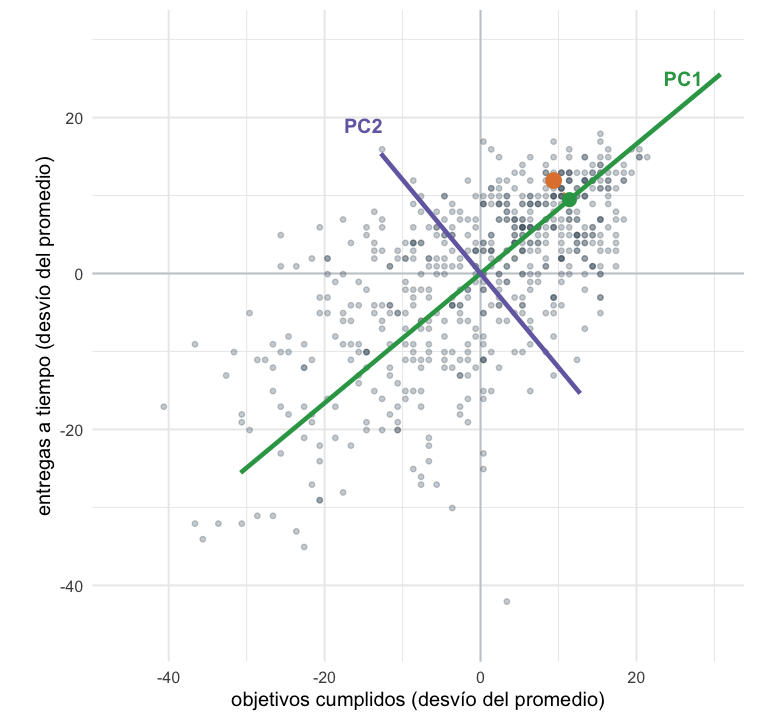
PC1 es la recta que mejor resume la nube, y hay dos maneras equivalentes de decirlo:
- la dirección en la que las proyecciones (las notas) quedan más desparramadas;
- la recta que queda más cerca de los puntos, midiendo la distancia en perpendicular.
Son lo mismo por Pitágoras: lo que cada punto no tiene sobre la recta, lo tiene como distancia a ella, y el total no cambia. No es la recta de regresión, que mide la distancia en vertical porque predice una variable desde la otra: acá no hay nada que predecir.
3. Las once a la vez
La misma receta con las once medidas. Una diferencia: como están en unidades distintas, antes de PCA las estandarizamos (a cada una le restamos su promedio y la dividimos por su desvío). En prcomp() eso es un argumento: scale. = TRUE. En la sección 4 vemos qué pasa si no lo hacemos.
✏️ Consigna 3
Hacé el PCA de las once medidas, estandarizadas.
Pistas:
- es el mismo
prcomp(), ahora sobreX; scale. = TRUEle pide que estandarice cada medida antes (ojo con el punto después descale).
# TODO: las once medidas, estandarizadas
pca <- prcomp(___, scale. = ___)

loadings <- data.frame(PC1 = pca$rotation[, "PC1"], PC2 = pca$rotation[, "PC2"])
round(loadings[order(-loadings$PC1), ], 2)
Leelo columna por columna:
- en PC1 pesan parecido, alrededor de 0,4, las seis medidas de cumplimiento (objetivos, líder, entregas, tareas, OKR, foco), y retrabajos pesa en negativo: más retrabajos, menos nota. Las cuatro de colaboración casi no pesan;
- en PC2 es al revés: pesan las cuatro de colaboración (mentoría, revisiones, pares, iniciativas) y el resto casi nada.
Nadie le dijo a PCA que había dos grupos. Los dos bloques de la matriz de correlaciones aparecen como dos componentes, y el nombre se lo ponemos nosotros: PC1 = cumplimiento, PC2 = colaboración. Otra persona podría llamar a PC1 “productividad”: el nombre es una interpretación.
¿Con cuántas componentes nos quedamos? Primero la tabla de varianza explicada, componente por componente y acumulada.
proporcion <- pca$sdev^2 / sum(pca$sdev^2)

varianza <- data.frame(
  componente = 1:length(MEDIDAS),
  varianza_explicada = proporcion,
  acumulada = cumsum(proporcion)
)
round(varianza, 3)| componente | varianza_explicada | acumulada |
|---|---|---|
| <dbl> | <dbl> | <dbl> |
| 1 | 0.404 | 0.404 |
| 2 | 0.217 | 0.621 |
| 3 | 0.058 | 0.679 |
| 4 | 0.055 | 0.733 |
| 5 | 0.047 | 0.781 |
| 6 | 0.046 | 0.826 |
| 7 | 0.041 | 0.867 |
| 8 | 0.039 | 0.906 |
| 9 | 0.036 | 0.943 |
| 10 | 0.031 | 0.974 |
| 11 | 0.026 | 1.000 |
El scree plot es esa tabla dibujada. Se busca el codo: el punto desde el cual cada componente nueva agrega poco, y se retienen las de antes del codo.
varianza$color <- c("PC1", "PC2", rep("resto", length(MEDIDAS) - 2))

options(repr.plot.width = 7.5, repr.plot.height = 4.2)
figura <- ggplot(varianza, aes(componente, varianza_explicada)) +
  geom_col(aes(fill = color), show.legend = FALSE) +
  geom_line(colour = "#b0572f") +
  geom_point(colour = "#b0572f", size = 2.5) +
  geom_hline(yintercept = 1 / length(MEDIDAS), linetype = "dashed", colour = GRAFITO) +
  annotate("text", x = 8, y = 1 / length(MEDIDAS) + 0.02, label = "lo que aporta una medida sola (1/11)", colour = GRAFITO) +
  scale_fill_manual(values = c(PC1 = VERDE, PC2 = VIOLETA, resto = "#aab4bd")) +
  scale_x_continuous(breaks = 1:length(MEDIDAS)) +
  labs(x = "componente", y = "proporción de varianza explicada") +
  theme_minimal(base_size = 12)

if (dir.exists(CARPETA_FIGURAS)) {
  ggsave(file.path(CARPETA_FIGURAS, "clase09_scree_r.png"), figura, width = 7.5, height = 4.2, dpi = 150)
}
figura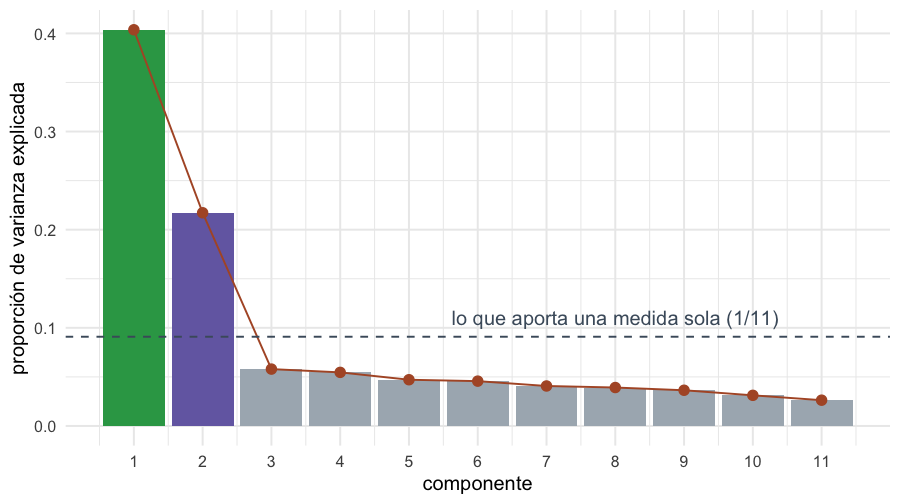
Las dos primeras explican cerca del 62 % entre las dos, y desde la tercera la línea se aplana: el codo está en la 3, así que nos quedamos con dos. El libro lo admite con todas las letras: el codo es un criterio a ojo.
Otra regla muy usada es quedarse con las componentes que explican más que una medida sola (la línea punteada, 1/11). Con datos estandarizados eso equivale a una varianza mayor que 1, que es la regla de Kaiser. Acá también da dos:
cat("varianza de cada componente:", round(pca$sdev^2, 2), "\n")
cat("componentes con varianza mayor que 1:", sum(pca$sdev^2 > 1), "\n")
varianza de cada componente: 4.44 2.39 0.64 0.6 0.52 0.5 0.45 0.43 0.4 0.34 0.29
componentes con varianza mayor que 1: 2 El biplot junta todo: cada punto es un empleado ubicado según su nota en PC1 y en PC2, y cada flecha es una medida, dibujada con sus dos loadings. Las flechas que apuntan juntas son medidas que se mueven juntas. R trae biplot(pca) listo, pero con once flechas queda ilegible; lo armamos con ggplot para elegir colores y etiquetas.
notas <- data.frame(PC1 = pca$x[, "PC1"], PC2 = pca$x[, "PC2"])

escala <- 4.6 / max(abs(loadings))
flechas <- data.frame(
  x = loadings$PC1 * escala,
  y = loadings$PC2 * escala,
  grupo = ifelse(abs(loadings$PC1) > abs(loadings$PC2), "cumplimiento", "colaboración")
)

options(repr.plot.width = 7, repr.plot.height = 6.5)
figura <- ggplot(notas, aes(PC1, PC2)) +
  geom_hline(yintercept = 0, colour = "#c5ccd3") +
  geom_vline(xintercept = 0, colour = "#c5ccd3") +
  geom_point(colour = GRAFITO, alpha = 0.25, size = 1) +
  geom_segment(data = flechas, aes(x = 0, y = 0, xend = x, yend = y, colour = grupo),
               arrow = arrow(length = unit(0.25, "cm")), linewidth = 1, show.legend = FALSE) +
  scale_colour_manual(values = c(cumplimiento = VERDE, "colaboración" = VIOLETA)) +
  annotate("text", x = 5.2, y = 0.8, label = "cumplimiento\n(6 medidas)", colour = VERDE, fontface = "bold") +
  annotate("text", x = 2.6, y = 5, label = "colaboración (4 medidas)", colour = VIOLETA, fontface = "bold") +
  annotate("text", x = -3.8, y = 0.7, label = "retrabajos", colour = VERDE, fontface = "bold") +
  coord_equal(xlim = c(-7, 7), ylim = c(-6, 7)) +
  labs(x = "PC1: cumplimiento", y = "PC2: colaboración") +
  theme_minimal(base_size = 12)

if (dir.exists(CARPETA_FIGURAS)) {
  ggsave(file.path(CARPETA_FIGURAS, "clase09_biplot_r.png"), figura, width = 7, height = 6.5, dpi = 150)
}
figura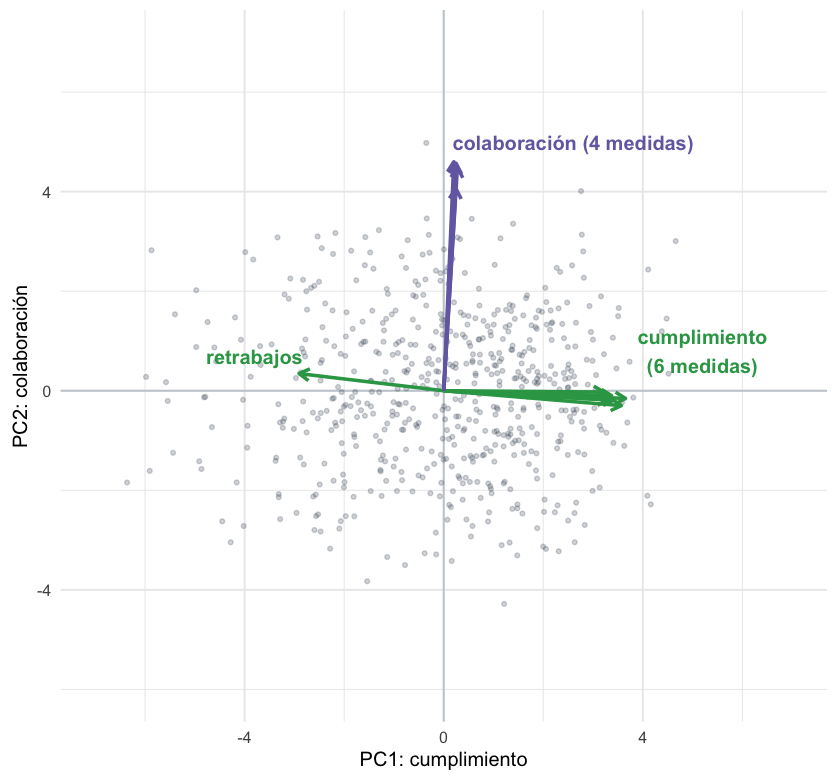
Las seis flechas verdes de cumplimiento se pisan porque apuntan casi igual, y por eso no les pusimos un nombre a cada una: justamente eso queremos ver. Retrabajos apunta al revés, y las cuatro violetas de colaboración van hacia arriba, a 90 grados: no tienen que ver con las otras.
4. ¿Y si no escalamos?
PCA busca la dirección de máxima varianza. Si una medida tiene una varianza enorme solo por su unidad, se queda con PC1. Miremos la varianza de cada medida en sus unidades originales.
round(sort(apply(X, 2, var), decreasing = TRUE), 2)- minutos_mentoria_mes
- 6873.53
- objetivos_cumplidos_pct
- 153.44
- entregas_a_tiempo_pct
- 119.79
- tareas_cerradas_mes
- 77.29
- revisiones_a_otros_mes
- 32.99
- horas_foco_semana
- 15.57
- retrabajos_mes
- 2.14
- iniciativas_internas_anio
- 1.62
- evaluacion_lider
- 0.45
- evaluacion_pares
- 0.31
- okr_score
- 0.01
Minutos de mentoría tiene una varianza de casi 7.000; la siguiente, alrededor de 150. Hacemos PCA solo centrando, sin estandarizar (scale. = FALSE, que es lo que hace prcomp() si no le decimos nada):
pca_crudo <- prcomp(X, scale. = FALSE)

cat("PC1 sin escalar explica:", round(pca_crudo$sdev[1]^2 / sum(pca_crudo$sdev^2), 3), "\n\n")
round(sort(abs(pca_crudo$rotation[, "PC1"]), decreasing = TRUE), 3)
PC1 sin escalar explica: 0.946
- minutos_mentoria_mes
- 0.999
- revisiones_a_otros_mes
- 0.037
- iniciativas_internas_anio
- 0.007
- objetivos_cumplidos_pct
- 0.004
- evaluacion_pares
- 0.003
- entregas_a_tiempo_pct
- 0.003
- tareas_cerradas_mes
- 0.002
- horas_foco_semana
- 0.002
- retrabajos_mes
- 0
- evaluacion_lider
- 0
- okr_score
- 0
Sin escalar, PC1 es minutos de mentoría y nada más: explica casi el 95 %, y no porque la mentoría sea lo más importante del desempeño, sino porque está medida en minutos. Si la midiéramos en horas, desaparecería. Salvo que todas las medidas estén en la misma unidad, se escala siempre.
Hay más de una forma de escalar. Estandarizar es el z-score; min-max lleva cada medida al rango de 0 a 1, restando el mínimo y dividiendo por el rango. scale() hace las dos cosas si le pasamos qué restar y por qué dividir. Para este análisis dan la misma estructura:
minimos <- apply(X, 2, min)
maximos <- apply(X, 2, max)
X_minmax <- scale(X, center = minimos, scale = maximos - minimos)

pca_minmax <- prcomp(X_minmax)

cat("z-score, varianza de las 3 primeras:", round((pca$sdev^2 / sum(pca$sdev^2))[1:3], 3), "\n")
cat("min-max, varianza de las 3 primeras:", round((pca_minmax$sdev^2 / sum(pca_minmax$sdev^2))[1:3], 3), "\n")
z-score, varianza de las 3 primeras: 0.404 0.217 0.058
min-max, varianza de las 3 primeras: 0.384 0.235 0.067 5. PC1 y la renuncia
PCA no miró la renuncia en ningún momento. Pero ya tenemos una nota de cumplimiento para cada empleado: ¿sirve para predecir quién se va?
datos$renuncio <- datos$renuncia == "Si"
datos$pc1 <- pca$x[, "PC1"]

round(tapply(datos$pc1, datos$renuncio, mean), 2)- FALSE
- 0.45
- TRUE
- -2.21
datos$grupo <- ifelse(datos$renuncio, "renunciaron", "se quedaron")

options(repr.plot.width = 7.5, repr.plot.height = 3.8)
figura <- ggplot(datos, aes(pc1, after_stat(density), fill = grupo)) +
  geom_histogram(bins = 30, position = "identity", alpha = 0.5) +
  scale_fill_manual(values = c("se quedaron" = GRAFITO, "renunciaron" = "#d6604d"), name = NULL) +
  labs(x = "nota en PC1 (cumplimiento)", y = "proporción") +
  theme_minimal(base_size = 12)

if (dir.exists(CARPETA_FIGURAS)) {
  ggsave(file.path(CARPETA_FIGURAS, "clase09_pc1_renuncia_r.png"), figura, width = 7.5, height = 3.8, dpi = 150)
}
figura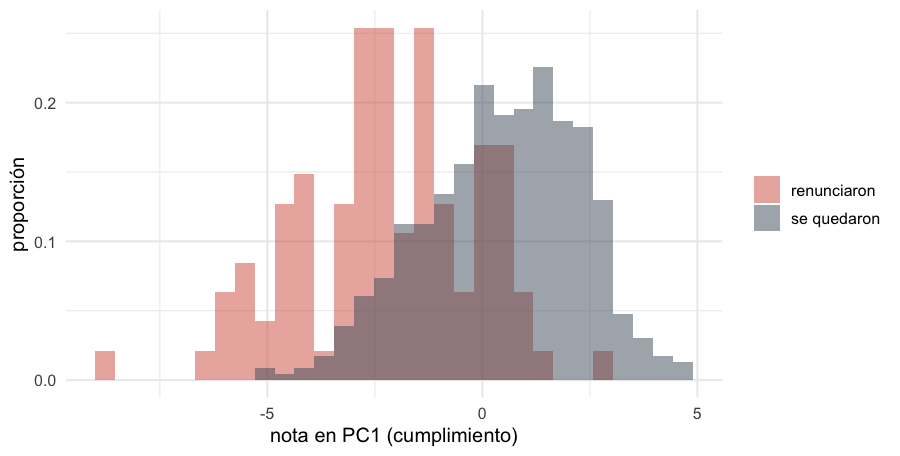
Los que renunciaron tienen, en promedio, bastante menos cumplimiento. Lo medimos con la AUC y validación cruzada repetida, como en la clase 8.
R base no trae ni la AUC ni una validación cruzada que acepte pasos de preprocesado, así que acá van dos funciones ya escritas. No hace falta modificarlas, pero sí leerlas:
auc()usa una forma equivalente de la AUC: la proporción de pares (uno que renunció, uno que se quedó) en los que el que renunció tiene el puntaje más alto.rank()hace esa cuenta sin armar los pares a mano.validacion_cruzada_pca()reparte a los 600 en 5 grupos, 10 veces. En cada vuelta ajusta el PCA solo con el entrenamiento, calcula las notas del testeo conpredict()usando esos loadings, entrena una logística con las primerasn_componentesy mide la AUC en el testeo.
Esa segunda función es lo que en Python hace un Pipeline: todo lo que aprende de los datos (el promedio, el desvío, los loadings) se aprende adentro de cada fold. En la sección 6 vemos por qué importa. En R, el paquete tidymodels tiene la misma idea (recipe con step_normalize y step_pca, dentro de un workflow).
Una diferencia con Python: acá los grupos se sortean sin estratificar (sin forzar la misma proporción de renuncias en cada uno). Con 600 empleados casi no cambia el resultado, y la función queda más corta.
auc <- function(puntaje, clase) {
  rangos <- rank(puntaje)
  n_si <- sum(clase)
  n_no <- sum(!clase)
  (sum(rangos[clase]) - n_si * (n_si + 1) / 2) / (n_si * n_no)
}

validacion_cruzada_pca <- function(n_componentes, escalar) {
  set.seed(SEED)
  aucs <- c()
  for (repeticion in 1:10) {
    grupo <- sample(rep(1:5, length.out = nrow(X)))
    for (k in 1:5) {
      pca_fold <- prcomp(X[grupo != k, ], scale. = escalar)
      entrenamiento <- data.frame(pca_fold$x[, 1:n_componentes, drop = FALSE])
      entrenamiento$renuncio <- datos$renuncio[grupo != k]
      testeo <- data.frame(predict(pca_fold, X[grupo == k, ])[, 1:n_componentes, drop = FALSE])

      modelo <- glm(renuncio ~ ., data = entrenamiento, family = binomial)
      aucs <- c(aucs, auc(predict(modelo, testeo), datos$renuncio[grupo == k]))
    }
  }
  mean(aucs)
}
Comparamos tres modelos de regresión logística:
- con las once medidas, estandarizadas. Usar las 11 componentes es lo mismo que usar las 11 medidas: son las mismas columnas, giradas, y a la logística le da igual;
- con una sola columna: la nota en PC1;
- con PC1 pero sin escalar.
✏️ Consigna 4
Medí la AUC de los tres modelos con validacion_cruzada_pca().
Pistas:
- el primer argumento es cuántas componentes usa la logística: 11 son todas las medidas, 1 es solo PC1;
- el segundo,
escalar, esTRUEoFALSE.
auc_once <- validacion_cruzada_pca(11, escalar = TRUE)
# TODO: una sola componente, estandarizando
auc_pc1 <- validacion_cruzada_pca(___, escalar = ___)
# TODO: una sola componente, SIN estandarizar
auc_crudo <- validacion_cruzada_pca(___, escalar = ___)

round(c("las 11 medidas" = auc_once, "solo PC1" = auc_pc1, "PC1 sin escalar" = auc_crudo), 3)
Con una columna la AUC es la misma que con once: comprimimos once medidas en una sin perder poder predictivo. Sin escalar, PC1 pasa a ser minutos de mentoría y la AUC cae a la de tirar una moneda (0,5).
Dos cuidados.
- Que PC1 prediga la renuncia es una propiedad de estos datos, no de PCA. PCA no mira la renuncia: busca la dirección de más varianza, y acá coincide con la que cae antes de irse porque Nimbus se armó así. En otros datos la componente que más varía puede no tener nada que ver con lo que querés predecir.
- Se pierde interpretabilidad. El coeficiente de PC1 dice “más cumplimiento, menos renuncia”, pero ya no puede decir cuál de las once medidas es la que importa. Si la pregunta es explicativa, eso pesa.
6. Leakage: el experimento del ruido
Escalar, PCA y elegir variables aprenden algo de los datos (la media y el desvío, los loadings, cuáles variables sirven). Si lo aprenden con todos los datos antes de partir en entrenamiento y testeo, el testeo ya ayudó a armar el modelo: eso es leakage, fuga de información.
Con el escalado en Nimbus el efecto es chico. Para ver cuánto puede engañar, repetimos un experimento clásico del libro de Hastie, Tibshirani y Friedman, con datos simulados:
- 50 personas y 5.000 variables sacadas al azar;
- una respuesta también al azar, mitad sí y mitad no: por construcción, nada la puede predecir;
- un paso de preprocesado: elegir las 100 variables más correlacionadas con la respuesta;
- una logística evaluada con validación cruzada.
Con 100 variables y 40 personas para entrenar, la logística de glm() no tiene solución única; la de glmnet con un freno chico (alpha = 0, la regularización ridge de la clase 5) sí. La logística de scikit-learn trae ese mismo freno por defecto.
Lo hacemos de dos maneras, en 20 datasets simulados distintos: eligiendo las 100 variables con todos los datos y después validando, y eligiéndolas adentro de cada fold, solo con el entrenamiento. order(-abs(cor(...)))[1:100] ordena las variables de la correlación más fuerte a la más débil, sin importar el signo, y se queda con las 100 primeras.
✏️ Consigna 5
La parte “mal” del experimento ya está escrita. Completá la parte “bien”: las 100 variables se eligen de nuevo en cada fold, mirando solo el entrenamiento.
Pistas:
- es la misma línea que
elegidas_afuera, pero sobre las filas de entrenamiento; entrenavaleTRUEen las filas de entrenamiento de ese fold: usala para quedarte con esas filas deX_ruidoy dey_ruido.
library(glmnet)

auc_afuera <- c()
auc_adentro <- c()

for (semilla in 1:20) {
  set.seed(semilla)
  X_ruido <- matrix(rnorm(50 * 5000), nrow = 50)
  y_ruido <- rep(c(FALSE, TRUE), each = 25)

  # Mal: se eligen las 100 variables mirando a las 50 personas, antes de partir.
  elegidas_afuera <- order(-abs(cor(X_ruido, y_ruido)))[1:100]

  mal <- c()
  bien <- c()
  for (repeticion in 1:5) {
    grupo <- sample(rep(1:5, length.out = 50))
    for (k in 1:5) {
      entrena <- grupo != k

      modelo <- glmnet(X_ruido[entrena, elegidas_afuera], y_ruido[entrena], family = "binomial", alpha = 0, lambda = 0.1)
      mal <- c(mal, auc(predict(modelo, X_ruido[!entrena, elegidas_afuera]), y_ruido[!entrena]))

      # TODO: elegí las 100 variables de nuevo, solo con las filas de entrenamiento
      elegidas_adentro <- order(-abs(cor(X_ruido[___, ], y_ruido[___])))[1:100]
      modelo <- glmnet(X_ruido[entrena, elegidas_adentro], y_ruido[entrena], family = "binomial", alpha = 0, lambda = 0.1)
      bien <- c(bien, auc(predict(modelo, X_ruido[!entrena, elegidas_adentro]), y_ruido[!entrena]))
    }
  }
  auc_afuera <- c(auc_afuera, mean(mal))
  auc_adentro <- c(auc_adentro, mean(bien))
}

cat("eligiendo con todos los datos, AUC promedio: ", round(mean(auc_afuera), 3), "\n")
cat("eligiendo adentro de cada fold, AUC promedio:", round(mean(auc_adentro), 3), "\n")
Con ruido puro, elegir las variables con todos los datos da una AUC perfecta. Es falsa: entre 5.000 variables al azar siempre hay algunas que coinciden por casualidad con la respuesta de esas 50 personas, y como las elegimos mirando a todas, también miramos a las que después hacen de testeo. Cuando la elección se hace adentro de cada fold, las coincidencias casuales del entrenamiento no se repiten en gente nueva, y la AUC da lo que tiene que dar: alrededor de 0,5.
La regla: todo lo que aprende algo de los datos se ajusta adentro de cada fold, solo con el entrenamiento. Es lo que hace validacion_cruzada_pca() con el PCA, y lo que en Python garantiza el Pipeline.
7. ¿Cuántas componentes? Que decida la validación cruzada
El codo del scree plot es un criterio a ojo. Si el objetivo es predecir, hay una forma mejor: probar. Como la cantidad de componentes es un argumento de validacion_cruzada_pca(), alcanza con un for que pruebe de 1 a 11, igual que buscábamos la profundidad de un árbol en la clase 8.
✏️ Consigna 6
Medí la AUC con 1, 2, …, 11 componentes.
Pistas:
- el
forrecorre las cantidades de componentes, de 1 alength(MEDIDAS); - adentro,
validacion_cruzada_pca(n, escalar = TRUE), y el resultado se guarda en la posiciónndeauc_por_componentes.
auc_por_componentes <- c()
# TODO: de 1 a la cantidad de medidas
for (n in 1:___) {
  # TODO: la AUC con n componentes, estandarizando
  auc_por_componentes[n] <- validacion_cruzada_pca(___, escalar = TRUE)
}

data.frame(componentes = 1:length(MEDIDAS), auc = round(auc_por_componentes, 3))
Con una sola componente ya estamos en la mejor AUC, y agregar más no mejora: una meseta. Para predecir la renuncia alcanza con la nota de cumplimiento.
8. Más allá de lo lineal
PCA solo encuentra direcciones rectas. Nimbus no tiene otra forma de estructura, así que para verlo usamos un clásico: 1.797 imágenes de dígitos escritos a mano, de 8 × 8 píxeles (el dataset Optical Recognition of Handwritten Digits del repositorio UCI, el mismo que trae scikit-learn). Cada imagen es una fila de 64 números (cuánta tinta hay en cada píxel) y la columna 65 dice qué dígito es: una tabla como la de Nimbus, con 64 columnas en lugar de 11.
Comparamos PCA con t-SNE, un método que intenta que los puntos cercanos en las 64 dimensiones sigan cercanos en el dibujo. Los 64 píxeles están en la misma unidad, así que acá no se estandariza. Este paso tarda unos segundos.
library(Rtsne)

digitos <- read.csv("https://archive.ics.uci.edu/ml/machine-learning-databases/optdigits/optdigits.tes", header = FALSE)
pixeles <- as.matrix(digitos[, 1:64])
digito <- factor(digitos[, 65])

en_pca <- prcomp(pixeles)$x[, 1:2]

set.seed(SEED)
en_tsne <- Rtsne(pixeles, dims = 2, perplexity = 30, check_duplicates = FALSE)$Y

dos_metodos <- rbind(
  data.frame(x = en_pca[, 1], y = en_pca[, 2], metodo = "PCA", digito = digito),
  data.frame(x = en_tsne[, 1], y = en_tsne[, 2], metodo = "t-SNE", digito = digito)
)

options(repr.plot.width = 11, repr.plot.height = 5)
figura <- ggplot(dos_metodos, aes(x, y, colour = digito)) +
  geom_point(size = 0.8) +
  facet_wrap(~metodo, scales = "free") +
  scale_colour_brewer(palette = "Paired", name = "dígito") +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 12) +
  theme(axis.text = element_blank())

if (dir.exists(CARPETA_FIGURAS)) {
  ggsave(file.path(CARPETA_FIGURAS, "clase09_tsne_r.png"), figura, width = 11, height = 5, dpi = 150)
}
figura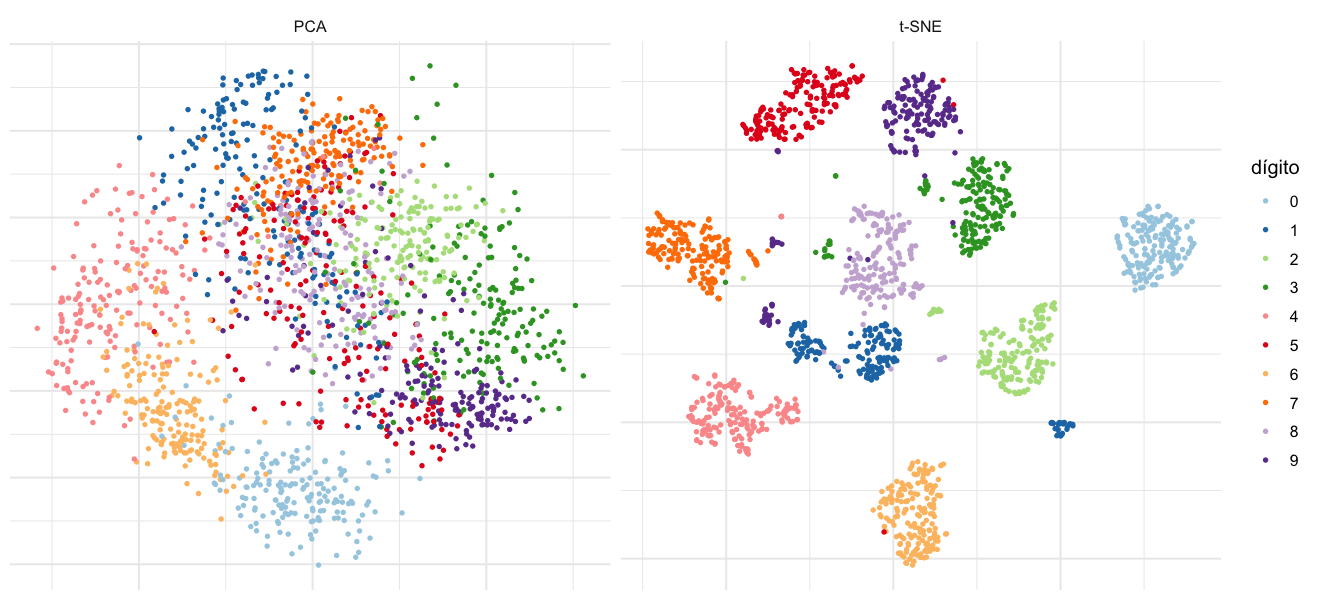
Con PCA los diez dígitos se pisan; con t-SNE aparecen separados. Hay estructura, pero no es recta.
Cada método sirve para otra cosa:
| PCA | t-SNE | |
|---|---|---|
| qué busca | direcciones rectas de máxima varianza | que los vecinos sigan siendo vecinos |
| se puede leer | sí: los loadings dicen qué pesa | no: los ejes no significan nada |
| da siempre lo mismo | sí | no: cambia con la semilla y con perplexity |
| se aplica a casos nuevos | sí, con predict() |
no |
| sirve para | resumir, armar índices, preparar datos para un modelo | mirar si hay grupos |
En t-SNE tampoco significan nada las distancias entre grupos ni su tamaño. UMAP es una alternativa más rápida que sí se aplica a casos nuevos; en R está en el paquete umap. La regla: con t-SNE y UMAP se descubre, con PCA se mide.
9. Ejercicio de cierre: la encuesta de clima
En la clase 5 usamos la encuesta de clima 2026 (nimbus_clima.csv): el índice de bienestar de cada empleado y 18 medidas más (horas extra, apoyo del equipo, reuniones, días de home office, cursos, etcétera). ¿Se comprimen tan bien como las once medidas de desempeño?
✏️ Consigna 7
Hacé un PCA sobre las 18 medidas de la encuesta de clima, sin el índice de bienestar, y mirá cuánta varianza explica cada componente.
Pistas:
setdiff(names(clima), c(...))da los nombres de todas las columnas menos esas: sacá"empleado_id"y"bienestar_laboral";- son medidas en unidades distintas: estandarizá, igual que en la sección 3;
- la varianza de cada componente es
$sdeval cuadrado: comparala con 1.
clima <- read.csv(paste0(BASE, "nimbus_clima.csv"))
# TODO: todas las columnas menos la del empleado y la del índice de bienestar
predictores <- clima[, setdiff(names(clima), c(___, ___))]

# TODO: el PCA de las medidas, estandarizadas
pca_clima <- prcomp(___, scale. = ___)

proporcion_clima <- pca_clima$sdev^2 / sum(pca_clima$sdev^2)
varianza_clima <- data.frame(
  componente = 1:ncol(predictores),
  varianza_explicada = proporcion_clima,
  acumulada = cumsum(proporcion_clima)
)

cat(ncol(predictores), "medidas\n")
# TODO: ¿cuántas componentes tienen varianza mayor que 1?
cat("componentes con varianza mayor que 1:", ___, "\n")
round(head(varianza_clima, 8), 3)
Ahora las dos curvas juntas, desempeño y clima, y la correlación más fuerte que hay entre dos medidas de cada tabla. diag(...) <- 0 pone en cero la diagonal, donde cada medida correlaciona consigo misma.
curvas <- rbind(
  data.frame(componente = varianza$componente, varianza_explicada = varianza$varianza_explicada, tabla = "desempeño (11 medidas)"),
  data.frame(componente = varianza_clima$componente, varianza_explicada = varianza_clima$varianza_explicada, tabla = "clima (18 medidas)")
)

options(repr.plot.width = 7.5, repr.plot.height = 4)
figura <- ggplot(curvas, aes(componente, varianza_explicada, colour = tabla)) +
  geom_line() +
  geom_point(size = 2) +
  scale_colour_manual(values = c("desempeño (11 medidas)" = VERDE, "clima (18 medidas)" = GRAFITO), name = NULL) +
  scale_x_continuous(breaks = 1:ncol(predictores)) +
  labs(x = "componente", y = "proporción de varianza explicada") +
  theme_minimal(base_size = 12) +
  theme(legend.position = "top")

if (dir.exists(CARPETA_FIGURAS)) {
  ggsave(file.path(CARPETA_FIGURAS, "clase09_scree_clima_r.png"), figura, width = 7.5, height = 4, dpi = 150)
}
print(figura)

valores_desempeno <- abs(cor(X))
diag(valores_desempeno) <- 0
valores_clima <- abs(cor(predictores))
diag(valores_clima) <- 0

cat("correlación más fuerte entre dos medidas de desempeño:", round(max(valores_desempeno), 2), "\n")
cat("correlación más fuerte entre dos medidas de clima:    ", round(max(valores_clima), 2), "\n")
correlación más fuerte entre dos medidas de desempeño: 0.7
correlación más fuerte entre dos medidas de clima: 0.44 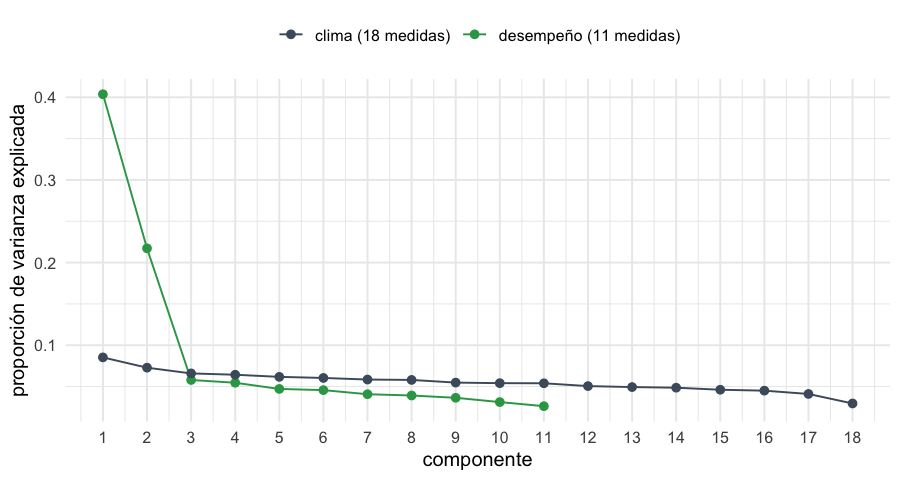
En clima no hay codo: la curva baja de a poco, y las dos primeras componentes juntan apenas 16 % de la varianza, contra 62 % en desempeño. Ninguna componente resume mucho más que una medida sola.
La razón está en la última línea: en desempeño hay medidas que se repiten entre sí, y en clima cada una dice algo bastante propio. PCA comprime redundancia: si no la hay, no tiene qué comprimir.
Mirá también la regla de Kaiser: en clima deja ocho componentes, cada una apenas por encima de 1. Cuando no hay estructura, una regla automática igual devuelve un número; por eso no se usa sola, sin mirar el scree plot.
10. Cierre
Lo que te llevás
- Reducir dimensiones es encontrar direcciones. Muchas medidas que se mueven juntas se resumen en pocas componentes; el nombre se lo ponemos nosotros, y a cambio se pierde la lectura directa de cada medida.
- PC1 es la dirección de máxima varianza, que es la misma recta que queda más cerca de los puntos. PC2, la máxima varianza que queda, a 90 grados.
- Loadings, scores y biplot. Los loadings son la receta; el score, la nota de cada caso; el biplot, las dos cosas en un dibujo.
- Cuántas componentes es una decisión. Para describir, el codo y la regla de Kaiser; para predecir, validación cruzada.
- Escalar antes, salvo que todo esté en la misma unidad.
- Todo lo que aprende de los datos se ajusta adentro de cada fold.
Todo el código de hoy, en pocas líneas
pca <- prcomp(X, scale. = TRUE)          # el PCA, estandarizando
summary(pca)                              # varianza explicada
pca$rotation[, 1:2]                       # loadings de PC1 y PC2
notas_nuevas <- predict(pca, X_nuevos)    # scores de casos nuevos, con los mismos loadings
Para seguir
- James y otros, capítulo 12, secciones 1 y 2, es la lectura de esta clase; la sección 6.3.1 cuenta cómo usar componentes para predecir.
- La clase que viene: clustering. ¿Hay grupos de empleados en el plano de cumplimiento y colaboración?