#@title Estilo de la clase (ejecutar, no hace falta leer) {display-mode: "form"}
from IPython.display import HTML, display

display(HTML(r"""
<style>
@import url('https://fonts.googleapis.com/css2?family=Work+Sans:wght@400;600&family=Amiri:wght@400;700&display=swap');
.rendered_html, .markdown, .cell .text_cell_render { font-family:'Work Sans',system-ui,sans-serif; color:#122535; }
.rendered_html h1,.rendered_html h2,.rendered_html h3 { font-family:'Amiri',Georgia,serif; color:#00529B; }
.rendered_html h2 { border-bottom:2px solid #00529B; padding-bottom:.2em; }
.rendered_html a { color:#00529B; }
.rendered_html table th { background:#00529B; color:#fff; }
.caja { background:#f3f5f7; border-left:4px solid #00529B; padding:.7em 1em; border-radius:4px; }
.ojo { background:#fdf3ec; border-left:4px solid #C8651B; padding:.7em 1em; border-radius:4px; }
</style>
"""))

# Colores de la clase: PC1 en verde y PC2 en violeta, como en las slides.
VERDE = "#31A354"
VIOLETA = "#756BB1"
AZUL = "#00529B"
GRAFITO = "#4A5B6B"Clase 10 · Clustering
Analítica de Datos · Maestría en Ciencias del Comportamiento · Universidad de San Andrés
Primavera 2026 · 10/10/2026

La clase pasada resumimos muchas medidas en pocas componentes. Hoy buscamos grupos de empleados que trabajan de forma parecida, sin que nadie nos diga de antemano cuáles son.
Al terminar esta notebook vas a poder:
- agrupar con K-means y ver los grupos,
- ver qué cambia con distintos K y elegir K con el método del codo,
- agrupar con clustering jerárquico,
- armar un dendrograma y elegir a mano la altura donde cortarlo.
Contenido
| # | Tema | La idea en una línea |
|---|---|---|
| 1 | Nueve medidas de cómo trabaja cada empleado | los datos de hoy |
| 2 | Mirar los datos con PCA | nueve medidas no se grafican; dos componentes sí |
| 3 | K-means | K grupos, distintos K y el codo |
| 4 | Clustering jerárquico | un árbol que se corta donde uno elige |
| 5 | Cierre | lo que te llevás |
1. Nueve medidas de cómo trabaja cada empleado
Nimbus registra, para cada uno de sus 600 empleados, nueve medidas de cómo trabaja: seis salen de las herramientas de trabajo (horas, reuniones, mensajes, contactos, capacitación) y tres de una encuesta (compromiso, agotamiento y si recomendaría la empresa). Están en nimbus_patrones.csv. Con ellas vamos a buscar grupos de empleados que trabajan parecido.
import os
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

SEED = 50

BASE = "https://raw.githubusercontent.com/tomdamelio/analitica_de_datos_alumnos/main/data/toy-nimbus/"

patrones = pd.read_csv(BASE + "nimbus_patrones.csv")

datos = patrones

MEDIDAS = [
    "horas_semana",
    "indice_compromiso",
    "horas_fuera_horario_semana",
    "minutos_reunion_semana",
    "mensajes_dia",
    "contactos_distintos_mes",
    "horas_capacitacion_mes",
    "agotamiento",
    "recomendaria_0a10",
]

X = datos[MEDIDAS]

print(X.shape[0], "empleados y", X.shape[1], "medidas")
X.head()
600 empleados y 9 medidas| horas_semana | indice_compromiso | horas_fuera_horario_semana | minutos_reunion_semana | mensajes_dia | contactos_distintos_mes | horas_capacitacion_mes | agotamiento | recomendaria_0a10 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 39.8 | 50.9 | 3.1 | 384 | 44 | 12 | 0.0 | 4.8 | 4 |
| 1 | 45.2 | 44.2 | 2.4 | 218 | 0 | 7 | 0.0 | 3.7 | 2 |
| 2 | 52.8 | 63.3 | 4.0 | 531 | 28 | 19 | 0.0 | 4.8 | 8 |
| 3 | 39.4 | 100.0 | 0.0 | 381 | 37 | 25 | 15.9 | 1.6 | 7 |
| 4 | 52.0 | 85.4 | 1.9 | 684 | 58 | 37 | 4.2 | 1.9 | 6 |
Mirá el promedio y el desvío (std) de cada medida:
X.describe().round(1)| horas_semana | indice_compromiso | horas_fuera_horario_semana | minutos_reunion_semana | mensajes_dia | contactos_distintos_mes | horas_capacitacion_mes | agotamiento | recomendaria_0a10 | |
|---|---|---|---|---|---|---|---|---|---|
| count | 600.0 | 600.0 | 600.0 | 600.0 | 600.0 | 600.0 | 600.0 | 600.0 | 600.0 |
| mean | 47.1 | 57.6 | 4.1 | 524.2 | 39.8 | 22.1 | 4.2 | 3.9 | 5.6 |
| std | 8.8 | 22.6 | 3.9 | 306.4 | 21.5 | 12.9 | 4.4 | 1.4 | 2.4 |
| min | 26.8 | 11.6 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 1.0 | 0.0 |
| 25% | 39.4 | 36.5 | 0.7 | 306.0 | 23.0 | 13.0 | 0.4 | 2.8 | 4.0 |
| 50% | 48.4 | 65.2 | 3.0 | 510.0 | 41.0 | 22.0 | 3.3 | 3.8 | 6.0 |
| 75% | 53.8 | 78.1 | 6.8 | 724.2 | 55.0 | 31.0 | 6.0 | 4.8 | 8.0 |
| max | 67.3 | 100.0 | 16.1 | 1516.0 | 97.0 | 61.0 | 19.5 | 7.0 | 10.0 |
Las medidas están en unidades muy distintas. Los minutos de reunión varían en cientos, pero el agotamiento en una escala de 1 a 7. K-means mide distancias entre empleados, entonces la medida con números más grandes dominaría todo. Por eso, igual que con PCA en la clase pasada, primero estandarizamos: a cada medida le restamos su promedio y la dividimos por su desvío.
from sklearn.preprocessing import StandardScaler

X_esc = StandardScaler().fit_transform(X)

pd.DataFrame(X_esc, columns=X.columns).describe().round(1)| horas_semana | indice_compromiso | horas_fuera_horario_semana | minutos_reunion_semana | mensajes_dia | contactos_distintos_mes | horas_capacitacion_mes | agotamiento | recomendaria_0a10 | |
|---|---|---|---|---|---|---|---|---|---|
| count | 600.0 | 600.0 | 600.0 | 600.0 | 600.0 | 600.0 | 600.0 | 600.0 | 600.0 |
| mean | -0.0 | 0.0 | 0.0 | 0.0 | 0.0 | -0.0 | 0.0 | -0.0 | -0.0 |
| std | 1.0 | 1.0 | 1.0 | 1.0 | 1.0 | 1.0 | 1.0 | 1.0 | 1.0 |
| min | -2.3 | -2.0 | -1.1 | -1.7 | -1.8 | -1.7 | -1.0 | -2.1 | -2.3 |
| 25% | -0.9 | -0.9 | -0.9 | -0.7 | -0.8 | -0.7 | -0.9 | -0.8 | -0.7 |
| 50% | 0.2 | 0.3 | -0.3 | -0.0 | 0.1 | -0.0 | -0.2 | -0.0 | 0.2 |
| 75% | 0.8 | 0.9 | 0.7 | 0.7 | 0.7 | 0.7 | 0.4 | 0.7 | 1.0 |
| max | 2.3 | 1.9 | 3.1 | 3.2 | 2.7 | 3.0 | 3.5 | 2.3 | 1.8 |
2. Mirar los datos con PCA
Nueve medidas son nueve dimensiones, y eso no se puede dibujar. Para mirar usamos lo de la clase pasada: PCA con dos componentes.
from sklearn.decomposition import PCA

pca = PCA(n_components=2)
pcs = pca.fit_transform(X_esc)

print("varianza explicada por PC1 y PC2:", pca.explained_variance_ratio_.round(3))

fig, ax = plt.subplots(dpi=150)
ax.scatter(pcs[:, 0], pcs[:, 1], s=8, color="gray", alpha=0.6)
ax.set_xlabel("PC1")
ax.set_ylabel("PC2")
ax.set_title("Los 600 empleados en PC1 y PC2")
varianza explicada por PC1 y PC2: [0.373 0.261]Text(0.5, 1.0, 'Los 600 empleados en PC1 y PC2')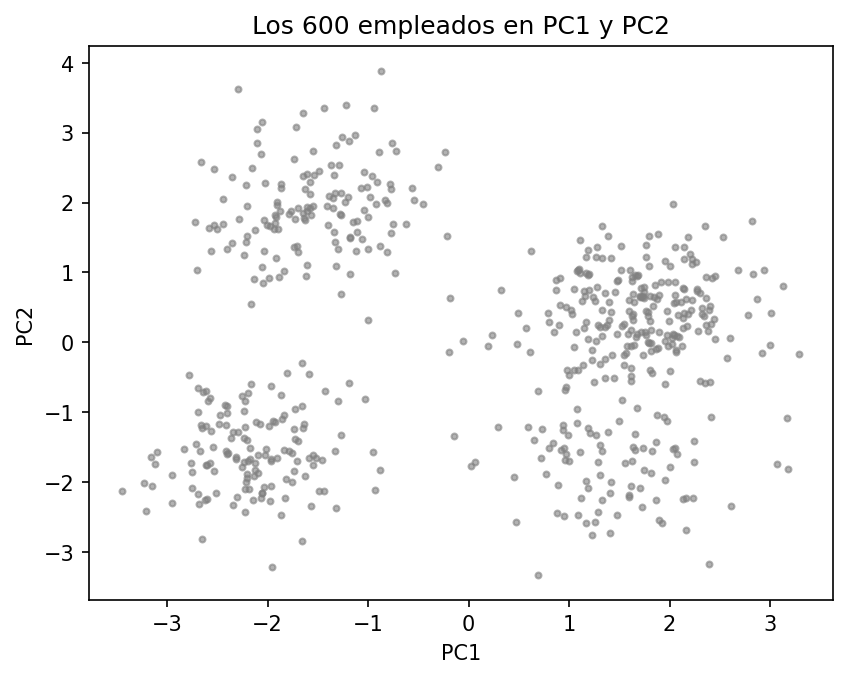
Entre las dos componentes resumen cerca del 63 % de la variación de las nueve medidas, y a ojo se ven cuatro nubes. ¿Lo confirma un método? Para eso está el clustering.
3. K-means
KMeans se usa como cualquier modelo de sklearn. Se crea, se ajusta con .fit() y se leen los resultados desde el mismo objeto. Tiene tres argumentos que importan:
n_clusters: la cantidad de grupos, K. La elegimos nosotros, como la K de KNN;n_init: cuántas veces corre el algoritmo con arranques distintos (se queda con la mejor corrida);random_state: la semilla, para que el resultado sea siempre el mismo.
Probemos con dos grupos:
from sklearn.cluster import KMeans

km = KMeans(n_clusters=2, n_init=10, random_state=SEED)
km.fit(X_esc)

grupos = km.labels_

print("empleados en cada grupo:")
print(pd.Series(grupos).value_counts())
print()
print("W (inertia_):", km.inertia_)
empleados en cada grupo:
1 318
0 282
Name: count, dtype: int64
W (inertia_): 3589.8186356528763labels_tiene el grupo de cada empleado: 0 o 1 (binario, le pedimos 2 clusters). El número no significa nada, es solo un nombre.inertia_es W, la variación dentro de los grupos: la suma de las distancias al cuadrado de cada empleado al centroide (el punto promedio) de su grupo. Cuanto más chica, más apretados los grupos.
Pintamos a cada empleado con su grupo, en el plano de PCA:
fig, ax = plt.subplots(dpi=150)
ax.scatter(pcs[:, 0], pcs[:, 1], c=grupos, cmap="tab10", s=8)
ax.set_xlabel("PC1")
ax.set_ylabel("PC2")
ax.set_title("K-means con K = 2")
plt.show()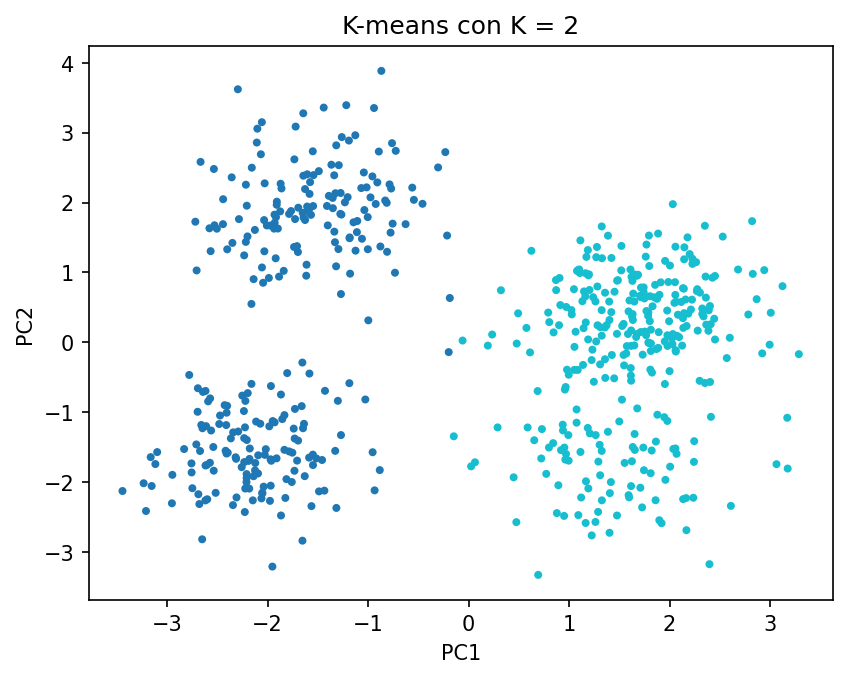
✏️ Consigna 1: ¿qué pasa con distintos K?
K-means siempre devuelve los K grupos que le pedís, haya o no haya K grupos en los datos. Probá con K = 2, 3, 4 y 6, y dibujá cada resultado en el plano de PCA, uno al lado del otro.
Pistas:
- adentro del
for,KMeans(n_clusters=k, ...)crea el modelo con la K de esa vuelta; - los grupos están en
km.labels_; pasáselos al gráfico enc=.
ks_prueba = [2, 3, 4, 6]

fig, axes = plt.subplots(1, 4, figsize=(14, 3.5), dpi=150, sharex=True, sharey=True)

for i in range(len(ks_prueba)):
    k = ks_prueba[i]
    # TODO: K-means con k grupos
    km = KMeans(n_clusters=___, n_init=10, random_state=SEED)
    km.fit(X_esc)

    ax = axes[i]
    # TODO: pintá cada punto con su grupo
    ax.scatter(pcs[:, 0], pcs[:, 1], c=___, cmap="tab10", s=6)
    ax.set_title("K = " + str(k) + "  (W = " + str(round(km.inertia_)) + ")")
    ax.set_xlabel("PC1")

axes[0].set_ylabel("PC2")
plt.show()
Con K = 2 y K = 3, K-means junta nubes que a ojo están separadas. Con K = 4, cada nube es un grupo. Con K = 6 parte nubes que estaban enteras: inventa grupos porque se los pedimos. Y W (en el título de cada panel) baja siempre que agregamos grupos, así que el K con menor W no sirve para elegir. Para eso está el codo.
✏️ Consigna 2: elegir K con el codo
Corré K-means para K de 1 a 8, guardá el W de cada uno y graficalo. Elegí K donde la curva deja de bajar “significativamente”. Si te fijás, parece como un codo.
Pistas:
- adentro del
for,KMeans(n_clusters=k, ...)crea el modelo con la K de esa vuelta; - después de
.fit(), el W está en.inertia_; agregalo a la lista conw.append(...).
ks = [1, 2, 3, 4, 5, 6, 7, 8]
w = []

for k in ks:
    # TODO: K-means con k grupos
    km = KMeans(n_clusters=___, n_init=10, random_state=SEED)
    km.fit(X_esc)
    # TODO: guardá el W de esta corrida
    w.append(___)

fig, ax = plt.subplots(dpi=150)
ax.plot(ks, w, marker="o")
ax.set_xlabel("K, cantidad de grupos")
ax.set_ylabel("W (inertia_)")
ax.set_title("El codo")
plt.show()
W siempre baja al agregar grupos (con 600 grupos, uno por empleado, sería cero), así que no se elige el K con menor W.
Se mira cuánto baja. Hasta K = 4 baja mucho, y desde ahí casi nada. El codo está en 4. Es una decisión a ojo, sí. Pero el libro lo admite, y es lo que se suele hacer.
Los cuatro grupos sobre PCA
Ajustamos K-means con el K que elegimos y pintamos a cada empleado con su grupo:
K = 4
km = KMeans(n_clusters=K, n_init=10, random_state=SEED)
km.fit(X_esc)
grupos = km.labels_

fig, ax = plt.subplots(dpi=150)
ax.scatter(pcs[:, 0], pcs[:, 1], c=grupos, cmap="tab10", s=8)
ax.set_xlabel("PC1")
ax.set_ylabel("PC2")
ax.set_title("K-means con K = 4")
Text(0.5, 1.0, 'K-means con K = 4')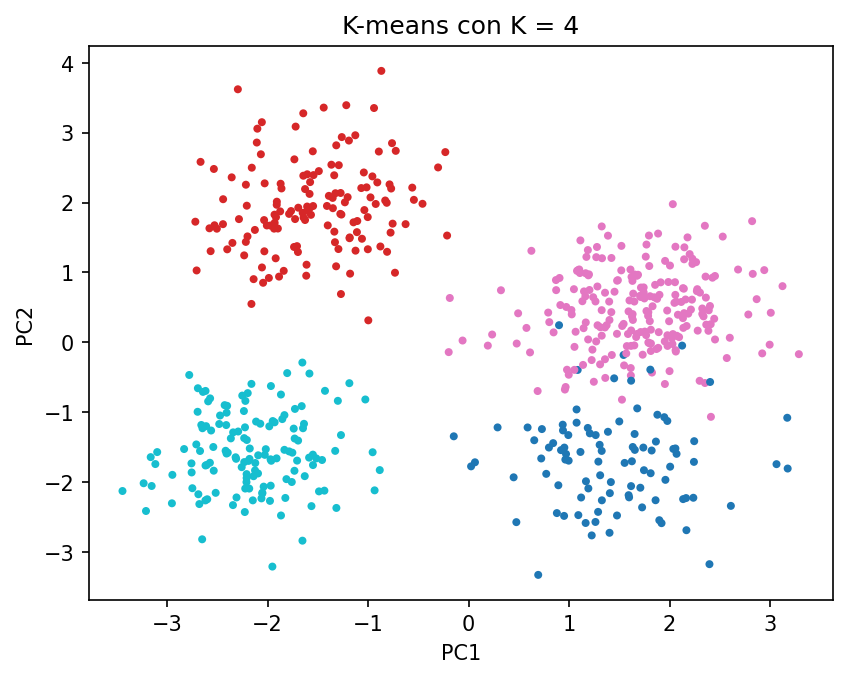
Los cuatro grupos de K-means coinciden con las cuatro nubes que se veían a ojo. Fijate que K-means no usó PC1 ni PC2: agrupó con las nueve medidas, y PCA solo nos dejó verlo.
4. Clustering jerárquico
El jerárquico no pide K de antemano. Arranca con cada empleado como un grupo solo, junta los dos más parecidos, y repite hasta que quedan todos juntos. Eso arma un árbol, el dendrograma. Usamos dos funciones de scipy:
linkage(datos, method=...)hace todas las fusiones.methodes el linkage: cómo se mide la distancia entre dos grupos. Usamos"ward", que junta los grupos que menos aumentan W;dendrogram(...)lo dibuja. Con 600 hojas no se lee nada, así que mostramos solo las 30 ramas de arriba (truncate_mode="lastp", p=30); el número entre paréntesis abajo de cada rama es cuántos empleados tiene.
from scipy.cluster.hierarchy import linkage, dendrogram, fcluster

Z = linkage(X_esc, method="ward")

fig, ax = plt.subplots(figsize=(9, 4), dpi=150)
dendrogram(Z, truncate_mode="lastp", p=30, ax=ax, color_threshold=0, above_threshold_color="gray")
ax.set_ylabel("altura de fusión")
ax.set_title("Dendrograma (Ward), 600 empleados")
Text(0.5, 1.0, 'Dendrograma (Ward), 600 empleados')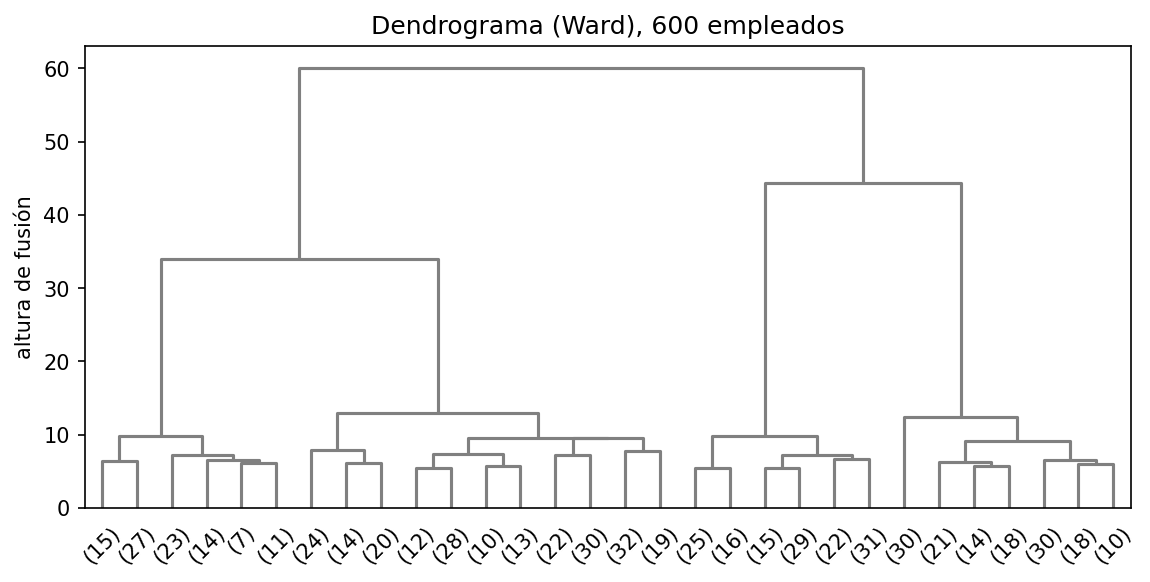
Se lee por la altura: cuanto más abajo se unen dos ramas, más parecidos son sus empleados. Que dos hojas estén al lado en el eje horizontal no dice nada.
Para formar grupos se corta el árbol con una línea horizontal: cada rama que cuelga por debajo de la línea es un grupo. Mové la altura y mirá cuántos grupos quedan:
from ipywidgets import FloatSlider, interact

def cortar(altura):
    fig, ax = plt.subplots(figsize=(9, 4), dpi=110)
    dendrogram(Z, truncate_mode="lastp", p=30, ax=ax, color_threshold=altura, above_threshold_color="gray")
    ax.axhline(altura, color="black", linestyle="--")
    ax.set_ylabel("altura de fusión")
    grupos_corte = fcluster(Z, t=altura, criterion="distance")
    ax.set_title("Cortando a altura " + str(round(altura, 1)) + ": " + str(len(set(grupos_corte))) + " grupos")
    plt.show()

interact(cortar, altura=FloatSlider(value=25, min=5, max=65, step=1));
Cortando entre 13 y 34, quedan cuatro grupos. Entre 34 y 44, tres. Más arriba, dos. Dónde cortar es, como casi siempre en machine learning, una decisión nuestra.
✏️ Consigna 3: elegir dónde cortar
Elegí una altura de corte mirando el dendrograma, dibujá la línea, cortá el árbol ahí y pintá los grupos que quedan en el plano de PCA.
Pistas:
ax.axhline(altura)dibuja la línea horizontal;fcluster(Z, t=altura, criterion="distance")devuelve el grupo de cada empleado si se corta a esa altura (los grupos se numeran desde 1);- el gráfico de PCA es el de K-means, con
c=grupos_arbol.
# TODO: la altura que elegiste mirando el dendrograma
altura = ___

fig, ax = plt.subplots(figsize=(9, 4), dpi=150)
dendrogram(Z, truncate_mode="lastp", p=30, ax=ax, color_threshold=altura, above_threshold_color="gray")
ax.axhline(altura, color="black", linestyle="--")
ax.set_ylabel("altura de fusión")
ax.set_title("Corte a mano")
plt.show()

# TODO: cortá el árbol a esa altura
grupos_arbol = fcluster(Z, t=___, criterion="distance")

print("empleados por grupo del árbol:")
print(pd.Series(grupos_arbol).value_counts().sort_index())

fig, ax = plt.subplots(dpi=150)
# TODO: pintá con los grupos del árbol
ax.scatter(pcs[:, 0], pcs[:, 1], c=___, cmap="tab10", s=8)
ax.set_xlabel("PC1")
ax.set_ylabel("PC2")
ax.set_title("Grupos del árbol, cortando a " + str(altura))
plt.show()
Cortando a 25 quedan cuatro grupos, y en el plano de PCA son las mismas cuatro nubes que encontró K-means, salvo unos pocos empleados en el borde entre dos nubes. Dos métodos distintos llegan casi al mismo lugar (los números de grupo no coinciden, porque son solo nombres). Si cortás más arriba, el árbol junta nubes, igual que K-means con K = 2 o 3.
5. Cierre
Lo que te llevás
- Clustering agrupa personas, no columnas. Cada empleado cae en un solo grupo.
- K-means busca el W más chico para la K que le pedimos, y siempre devuelve esa cantidad de grupos, existan o no.
- K es una decisión. W baja siempre; el codo ayuda, pero es a ojo.
- El dendrograma se lee por la altura y se corta donde uno elige: cada altura es una cantidad de grupos.
- Escalar antes de agrupar, porque todo lo que mide distancias depende de las unidades.
Todo el código de hoy, en pocas líneas
X_esc = StandardScaler().fit_transform(X)                     # escalar
pcs = PCA(n_components=2).fit_transform(X_esc)                # para mirar
km = KMeans(n_clusters=4, n_init=10, random_state=SEED)       # K-means
km.fit(X_esc)
grupos = km.labels_                                           # el grupo de cada empleado
w = km.inertia_                                               # W, para el codo
Z = linkage(X_esc, method="ward")                             # jerárquico
grupos_arbol = fcluster(Z, t=25, criterion="distance")        # cortar a mano
Para seguir
- James y otros, capítulo 12, sección 4, es la lectura de esta clase.
- La clase que viene: texto. Modelos de lenguaje, embeddings y sentimiento.