#@title Estilo de la clase (ejecutar, no hace falta leer) {display-mode: "form"}
from IPython.display import HTML, display

display(HTML(r"""
<style>
@import url('https://fonts.googleapis.com/css2?family=Work+Sans:wght@400;600&family=Amiri:wght@400;700&display=swap');
.rendered_html, .markdown, .cell .text_cell_render { font-family:'Work Sans',system-ui,sans-serif; color:#122535; }
.rendered_html h1,.rendered_html h2,.rendered_html h3 { font-family:'Amiri',Georgia,serif; color:#00529B; }
.rendered_html h2 { border-bottom:2px solid #00529B; padding-bottom:.2em; }
.rendered_html a { color:#00529B; }
.rendered_html table th { background:#00529B; color:#fff; }
.caja { background:#f3f5f7; border-left:4px solid #00529B; padding:.7em 1em; border-radius:4px; }
.ojo { background:#fdf3ec; border-left:4px solid #C8651B; padding:.7em 1em; border-radius:4px; }
</style>
"""))

# Colores de la clase: verde para "recomienda", naranja para "no recomienda".
VERDE = "#31A354"
NARANJA = "#E6550D"
AZUL = "#00529B"
GRAFITO = "#4A5B6B"

# Las figuras se guardan solo si existe la carpeta del repositorio (en Colab no).
import os
CARPETA_FIGURAS = "../assets/figures"

def guardar(fig, nombre):
    if os.path.isdir(CARPETA_FIGURAS):
fig.savefig(os.path.join(CARPETA_FIGURAS, nombre), dpi=150, bbox_inches="tight")Clase 11 · Análisis de texto
Analítica de Datos · Maestría en Ciencias del Comportamiento · Universidad de San Andrés
Primavera 2026 · 17/10/2026

Hasta ahora todos nuestros datos eran números o categorías. Pero mucho de lo que estudian las ciencias del comportamiento llega como texto: respuestas abiertas de encuestas, entrevistas, posteos, mensajes, notas de campo. Hoy vemos cómo convertir texto en algo que se puede contar, graficar y modelar.
Al terminar esta notebook vas a poder:
- limpiar texto y contar las palabras más frecuentes, en general y por grupo;
- medir el sentimiento con un diccionario, sin entrenar nada;
- armar una bolsa de palabras y entrenar un clasificador de textos;
- leer qué palabras usa el clasificador para decidir;
- reconocer qué problemas no resuelven estos métodos (y que vamos a retomar la clase que viene).
Contenido
| # | Tema | La idea en una línea |
|---|---|---|
| 1 | Los comentarios de la encuesta | los datos de hoy |
| 2 | Limpiar y contar palabras | antes de modelar, mirar |
| 3 | Sentimiento con un diccionario | contar palabras positivas y negativas |
| 4 | La bolsa de palabras | cada texto se vuelve una fila de números |
| 5 | Un clasificador de textos | que los datos digan qué palabras importan |
| 6 | Tu caja de herramientas | la receta para tu TP |
1. Los comentarios de la encuesta
En la encuesta anual, Nimbus le preguntó a cada empleado si recomendaría la empresa como lugar de trabajo, de 0 a 10 (es recomendaria_0a10, la usamos en la clase de clustering). Justo después venía una pregunta abierta: “¿Por qué pusiste esa nota?”. Las respuestas están en nimbus_comentarios.csv, una fila por empleado.
Son 600 comentarios. Nadie los va a leer uno por uno, y aunque alguien lo hiciera, no podría decir con precisión qué temas aparecen más ni en quiénes. Para eso sirve tratar el texto como datos.
import re
import unicodedata

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

SEED = 11

BASE = "https://raw.githubusercontent.com/tomdamelio/analitica_de_datos_alumnos/main/data/toy-nimbus/"

comentarios = pd.read_csv(BASE + "nimbus_comentarios.csv")
patrones = pd.read_csv(BASE + "nimbus_patrones.csv")

pd.set_option("display.max_colwidth", 120)
comentarios.head(10)| empleado_id | comentario | |
|---|---|---|
| 0 | 1 | La verdad, tengo la agenda llena de reuniones. |
| 1 | 2 | sinceramente, falta liderazgo y nadie toma decisiones. me escriben a cualquier hora, incluso de noche |
| 2 | 3 | estoy agotado, la carga es enorme. mi equipo quedó desarmado, se fue la mitad |
| 3 | 4 | Sin comentarios. |
| 4 | 5 | La verdad, mi lider me apoya y me da feedback. |
| 5 | 6 | Pagan poco para lo que exigen. Hace años que no tengo un ascenso. |
| 6 | 7 | Trabajo con gente muy capaz. Se respetan los horarios. Las reuniones son cortas y sirven. |
| 7 | 8 | En general, trabajo casi todos los fines de semana. Mi equipo quedó desarmado, se fue la mitad. |
| 8 | 9 | Se respetan los horarios. Hay mucha competencia interna. Pero hay muchos cursos y tiempo para hacerlos. |
| 9 | 10 | Para ser nuevo me siento muy comodo. Paso el dia en reuniones que no sirven para nada. |
Lo primero, como con cualquier dato: mirarlo. Ya en estas diez filas se ven cosas que en una tabla de números no pasan: textos con y sin tildes, en minúsculas, comentarios que mezclan cosas buenas y malas. Contemos cuántos están vacíos:
vacios = comentarios["comentario"].isna().sum()
print("comentarios en blanco:", vacios, "de", len(comentarios))

# Respuestas cortas (menos de 3 palabras)
largo = comentarios["comentario"].str.split().str.len()
print("comentarios de 3 palabras o menos:", (largo <= 3).sum())
comentarios[largo <= 3].tail(3)
comentarios en blanco: 29 de 600
comentarios de 3 palabras o menos: 24| empleado_id | comentario | |
|---|---|---|
| 522 | 523 | - |
| 549 | 550 | . |
| 560 | 561 | nada para agregar |
Las respuestas en blanco y las que no dicen nada no aportan, así que las sacamos. Después juntamos cada comentario con la nota que puso ese empleado, con un merge por empleado_id como en las clases anteriores, y definimos qué vamos a predecir: si el empleado recomienda la empresa (nota de 7 o más) o no.
datos = comentarios.dropna(subset=["comentario"]) # tiramos los nan
mascara = datos["comentario"].str.split().str.len() > 3 # filtramos quedandonos con longitud > 3
datos = datos[mascara]
datos = datos.merge(patrones[["empleado_id", "recomendaria_0a10"]], on="empleado_id")

datos["recomienda"] = (datos["recomendaria_0a10"] >= 7).astype(int) # nueva variable

print(len(datos), "comentarios con contenido")
print("proporción que recomienda:", datos["recomienda"].mean().round(3))
547 comentarios con contenido
proporción que recomienda: 0.393Quedan 547 comentarios, y el 39 % de esos empleados recomienda la empresa. Como viene siendo costumbre, si queremos predecir si los empleados recomiendan la empresa, un modelo que diga siempre “no recomienda” acierta el 61 %. Es la vara contra la que vamos a comparar todo lo demás.
2. Limpiar y contar palabras
Para la computadora, “Reunión”, “reunión” y “reunion” son tres cosas distintas. Antes de contar hay que normalizar: pasar todo a minúsculas y sacar las tildes (la ñ la dejamos, porque “campaña” y “campana” no son lo mismo). Armamos una función para eso, así la usamos siempre igual:
def limpiar(texto):
    texto = texto.lower()
    texto = texto.replace("ñ", "__enie__")
    texto = unicodedata.normalize("NFD", texto)
    texto = "".join(c for c in texto if unicodedata.category(c) != "Mn")   # saca las tildes
    texto = texto.replace("__enie__", "ñ")
    return texto

print(limpiar("Paso el día en REUNIONES que no sirven para nada."))
print(limpiar("Hace años que no tengo un ascenso."))
paso el dia en reuniones que no sirven para nada.
hace años que no tengo un ascenso.Después hay que tokenizar: partir el texto en palabras. La forma más simple es quedarse con las secuencias de letras con una expresión regular:
def tokenizar(texto):
    return re.findall(r"[a-zñ]+", limpiar(texto))

tokenizar("La verdad, mi líder me apoya y me da feedback.")
['la', 'verdad', 'mi', 'lider', 'me', 'apoya', 'y', 'me', 'da', 'feedback']Ya podemos contar. ¿Cuáles son las palabras más frecuentes en los 547 comentarios?
from collections import Counter

conteo = Counter()
for texto in datos["comentario"]:
    conteo.update(tokenizar(texto))

conteo.most_common(15)
[('me', 313),
('no', 245),
('la', 244),
('el', 218),
('que', 194),
('para', 177),
('hay', 135),
('de', 132),
('en', 130),
('mi', 119),
('y', 112),
('los', 109),
('nada', 109),
('reuniones', 103),
('las', 96)]Entre las más frecuentes están “me”, “de”, “la”, “el”, “que”. Estas son palabras que están en cualquier texto y no nos dan nada de información real sobre Nimbus. Se les llama stopwords, y hay listas armadas para cada idioma para identificarlas y filtrarlas. La de la librería nltk en castellano tiene 313:
import nltk
nltk.download("stopwords", quiet=True)
from nltk.corpus import stopwords

STOPWORDS = [limpiar(p) for p in stopwords.words("spanish")]
print(len(STOPWORDS), "stopwords.")
print("Algunas:", STOPWORDS[:12])
313 stopwords.
Algunas: ['de', 'la', 'que', 'el', 'en', 'y', 'a', 'los', 'del', 'se', 'las', 'por']Ojo con las stopwords. La lista de nltk incluye “no”, “nada”, “sin” y “poco”. Para contar temas no importan, pero para el sentimiento son clave: “no me siento valorado” sin el “no” queda “siento valorado”. Antes de usar una lista de stopwords, leela, y sacá las palabras que en tu problema sí importan.
for palabra in ["no", "nada", "sin", "poco", "nunca"]:
    print(palabra, "es stopword:", palabra in STOPWORDS)

NO_INCLUIR_STOPWORD = ["no", "nada", "sin", "poco", "nunca"]
STOPWORDS = [p for p in STOPWORDS if p not in NO_INCLUIR_STOPWORD]

print()
print(len(STOPWORDS), "stopwords ahora.")
no es stopword: True
nada es stopword: True
sin es stopword: True
poco es stopword: True
nunca es stopword: False
309 stopwords ahora.Y al revés: cada corpus tiene sus muletillas, palabras que no están en ninguna lista pero tampoco dicen nada. En Nimbus mucha gente arranca con “La verdad, …”, “Sinceramente, …” o “En general, …”. Las agregamos a mano. Encontrarlas es parte del trabajo, pero suelen aparecer la primera vez que contás palabras.
MULETILLAS = ["verdad", "sinceramente", "general"]
STOPWORDS = STOPWORDS + MULETILLAS

print(len(STOPWORDS), "stopwords ahora.")
312 stopwords ahora.Ahora sí, las palabras más frecuentes por grupo, en los que recomiendan la empresa y en los que no. Es el primer análisis que conviene hacer con cualquier corpus, y muchas veces ya responde la pregunta.
def palabras_frecuentes(textos):
    conteo = Counter()
    for texto in textos:
        conteo.update(palabra for palabra in tokenizar(texto) if palabra not in STOPWORDS)
    return pd.Series(conteo).sort_values(ascending=False).head(12)

frec_si = palabras_frecuentes(datos.loc[datos["recomienda"] == 1, "comentario"])
frec_no = palabras_frecuentes(datos.loc[datos["recomienda"] == 0, "comentario"])

fig, axes = plt.subplots(1, 2, figsize=(10, 4), dpi=150)
axes[0].barh(frec_si.index[::-1], frec_si.values[::-1], color=VERDE)
axes[0].set_title("Recomiendan")
axes[1].barh(frec_no.index[::-1], frec_no.values[::-1], color=NARANJA)
axes[1].set_title("No recomiendan")
for ax in axes:
    ax.set_xlabel("cantidad de veces")
fig.tight_layout()
plt.show()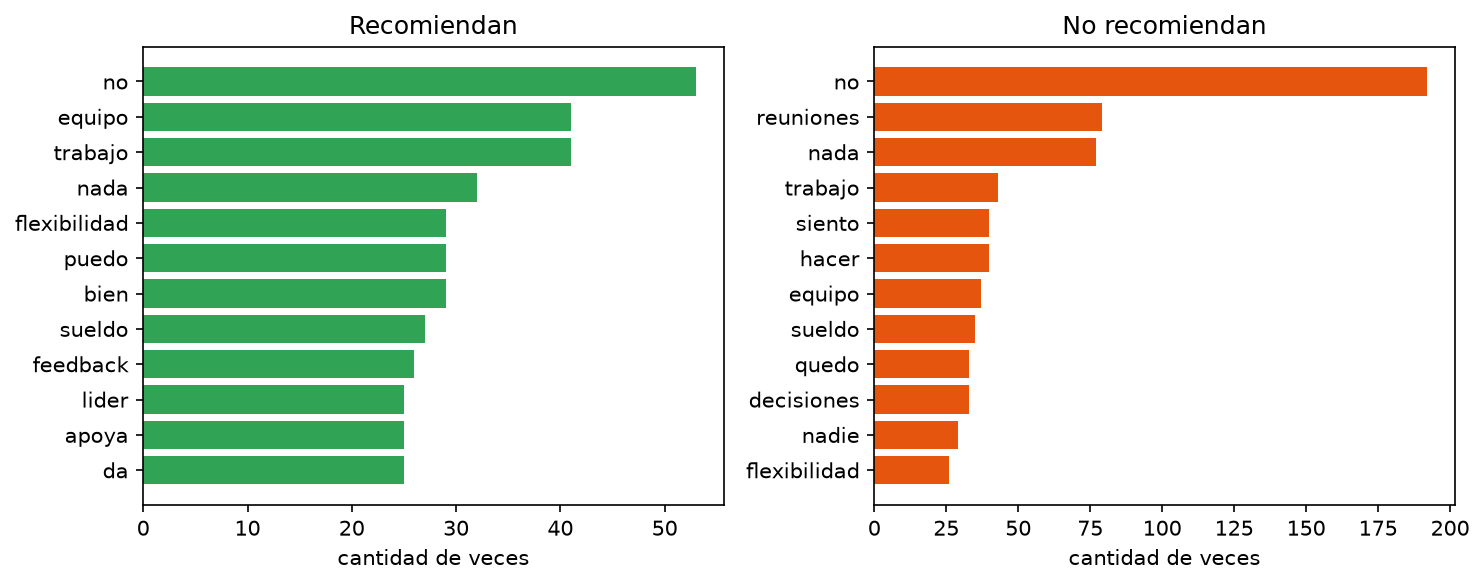
Sin ningún modelo ya aparece una historia: los que recomiendan hablan del equipo, de la flexibilidad, del líder que los apoya y les da feedback; los que no, de reuniones, de decisiones y de que nadie hace nada. Hay palabras en los dos lados (“trabajo”, “sueldo”) que hablan del tema pero no del tono. Y fijate que “no” es la más frecuente en los dos grupos, pero aparece 192 veces en los que no recomiendan y 53 en los que sí: si la hubiéramos sacado como stopword, perdíamos esa pista.
3. Sentimiento con un diccionario
La forma más directa de medir si un texto es positivo o negativo: armar una lista de palabras positivas y otra de palabras negativas, y contar. El puntaje de un comentario es
\[\text{puntaje} = (\text{cantidad de palabras positivas}) - (\text{cantidad de palabras negativas})\]
Si es mayor que cero, el comentario es positivo. No hay nada que entrenar, solo hace falta el diccionario. Por eso sirve aunque no tengas ninguna etiqueta, que es lo más común con respuestas abiertas.
Acá armamos uno chico a mano, mirando el tipo de comentarios que hay. Existen diccionarios ya armados para castellano, pero el razonamiento es el mismo.
POSITIVAS = [
    "bueno", "buena", "buenos", "excelente", "genial", "gusta", "encanta", "apoyo", "apoya",
    "valorado", "valoran", "flexibilidad", "aprendo", "creciendo", "comodo", "utiles", "sirven",
    "capaz", "mejor", "tranquilo", "clara", "escucha", "sentido",
]
NEGATIVAS = [
    "malo", "mala", "quemado", "agotado", "desmotivado", "caos", "poco", "aburro", "nunca",
    "falta", "falto", "nadie", "demasiadas", "eternas", "atrasado", "exigen", "competencia",
    "desarmado", "quejar", "estres", "cero",
]

def puntaje(texto):
    texto_tokenizado = tokenizar(texto)
    positivas = sum(palabra in POSITIVAS for palabra in texto_tokenizado)
    negativas = sum(palabra in NEGATIVAS for palabra in texto_tokenizado)
    return positivas - negativas

print(puntaje("Mi equipo es excelente y me encanta el proyecto."))
print(puntaje("Estoy agotado y nadie me escucha."))
2
-1¿El puntaje dice algo? Lo podemos comprobar contra la nota que puso cada empleado, que el diccionario no usó:
puntajes = []
for texto in datos["comentario"]:
    puntajes.append(puntaje(texto))

datos["puntaje"] = puntajes
promedio = datos.groupby("recomendaria_0a10")["puntaje"].mean()

r = datos["puntaje"].corr(datos["recomendaria_0a10"])
print("Correlación entre puntaje y nota:", round(r, 2))

fig, ax = plt.subplots()
ax.bar(promedio.index, promedio.values, color=[NARANJA if n < 7 else VERDE for n in promedio.index])
ax.axhline(0, color=GRAFITO, linewidth=0.8)
ax.set_xlabel("nota que puso (recomendaria_0a10)")
ax.set_ylabel("puntaje promedio del diccionario")
ax.set_title("El puntaje del diccionario sube con la nota")
guardar(fig, "clase11_diccionario_vs_nota.png")
plt.show()
Correlación entre puntaje y nota: 0.41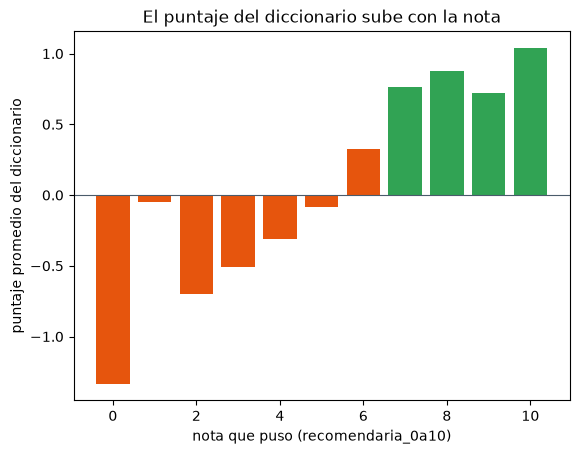
A mayor nota, mayor puntaje. Esto lo hicimos con una lista de 44 palabras armada en cinco minutos. Si lo usaramos para clasificar (puntaje mayor que cero = “recomienda”), ¿cuánto acierta?
pred_diccionario = (datos["puntaje"] > 0).astype(int)
acierto_diccionario = (pred_diccionario == datos["recomienda"]).mean()

print("Acierto del diccionario:", acierto_diccionario.round(3))
print("Acierto de decir siempre 'no recomienda':", 1 - datos["recomienda"].mean().round(3))
Acierto del diccionario: 0.658
Acierto de decir siempre 'no recomienda': 0.607Le gana a la vara, pero por poco. ¿Dónde se equivoca? Miremos comentarios de gente que sí recomienda (nota de 7 o más) y a los que el diccionario les dio un puntaje negativo:
errores = datos[(datos["recomienda"] == 1) & (datos["puntaje"] < 0)]
errores[["comentario", "recomendaria_0a10", "puntaje"]].head(6)| comentario | recomendaria_0a10 | puntaje | |
|---|---|---|---|
| 2 | estoy agotado, la carga es enorme. mi equipo quedó desarmado, se fue la mitad | 8 | -2 |
| 7 | Se respetan los horarios. Hay mucha competencia interna. Pero hay muchos cursos y tiempo para hacerlos. | 7 | -1 |
| 10 | En general, la carga de trabajo es razonable. No me puedo quejar del sueldo. | 8 | -1 |
| 17 | Demasiadas reuniones, no me queda tiempo para trabajar. | 8 | -1 |
| 21 | El clima en el equipo es malo. No me puedo quejar de la flexibilidad. Me dieron la oportunidad de liderar un proyecto. | 7 | -1 |
| 54 | En general, siento que mi trabajo no le importa a nadie. | 9 | -1 |
Hay dos tipos de error. Algunos no son culpa del diccionario, ya que hay gente que se queja e igualmente pone un 8, y ningún método que lea solo el texto lo va a acertar. Pero otros sí, como “No me puedo quejar del sueldo”, que es un elogio pero da sentimiento negativo. Un diccionario cuenta palabras sueltas, sin mirar qué tienen al lado.
4. La bolsa de palabras
La bolsa de palabras (bag of words) es la forma más usada de convertir textos en una tabla:
- cada fila es un texto;
- cada columna es una palabra del vocabulario (todas las palabras que aparecen en el corpus);
- cada celda dice cuántas veces aparece esa palabra en ese texto.
Se llama “bolsa” porque se pierde el orden: “no me siento valorado” y “me siento no valorado” dan la misma fila. Veámoslo con tres comentarios inventados. En sklearn la arma CountVectorizer:
from sklearn.feature_extraction.text import CountVectorizer

ejemplos = [
    "Mi equipo es excelente.",
    "El clima en el equipo es malo.",
    "No hay buen clima, no.",
]

vectorizador = CountVectorizer(preprocessor=limpiar)
X_ejemplo = vectorizador.fit_transform(ejemplos)

pd.DataFrame(X_ejemplo.toarray(), columns=vectorizador.get_feature_names_out(), index=ejemplos)| buen | clima | el | en | equipo | es | excelente | hay | malo | mi | no | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Mi equipo es excelente. | 0 | 0 | 0 | 0 | 1 | 1 | 1 | 0 | 0 | 1 | 0 |
| El clima en el equipo es malo. | 0 | 1 | 2 | 1 | 1 | 1 | 0 | 0 | 1 | 0 | 0 |
| No hay buen clima, no. | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 2 |
Cada texto quedó como una fila de números, y con eso ya se puede hacer todo lo que vimos en la materia: clasificar, agrupar, reducir dimensiones. preprocessor=limpiar le dice que antes de contar use nuestra función de limpieza.
Ahora con los 547 comentarios:
vec = CountVectorizer(preprocessor=limpiar, stop_words=STOPWORDS)
X = vec.fit_transform(datos["comentario"])

print("filas (comentarios):", X.shape[0])
print("columnas (palabras del vocabulario):", X.shape[1])
filas (comentarios): 547
columnas (palabras del vocabulario): 200Hay más columnas que en cualquier tabla que vimos hasta ahora, pero pensá que casi todas las celdas son cero, ya que cada comentario usa unas pocas palabras de todo el vocabulario. En un corpus real, con miles de textos, el vocabulario llega a decenas de miles de palabras.
5. Un clasificador de textos
Con la bolsa de palabras como X y recomienda como y, es un problema de clasificación como los de la clase 6. Usamos regresión logística: cada palabra recibe un coeficiente, y la probabilidad de “recomienda” sube o baja según las palabras que tenga el comentario.
Separamos entrenamiento y prueba como siempre, y armamos un Pipeline: primero la bolsa de palabras, después el modelo. Así el vocabulario se aprende solo con los textos de entrenamiento, y cualquier texto nuevo pasa por los mismos pasos.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline

X_train, X_test, y_train, y_test = train_test_split(
    datos["comentario"],
    datos["recomienda"],
    test_size=0.3,
    random_state=SEED,
    stratify=datos["recomienda"]
)

modelo = make_pipeline(
    CountVectorizer(preprocessor=limpiar, stop_words=STOPWORDS),
    LogisticRegression(max_iter=1000),
)
modelo.fit(X_train, y_train)

acierto_train = modelo.score(X_train, y_train)
acierto_test = modelo.score(X_test, y_test)
print(f"acierto en entrenamiento: {acierto_train:.3f}")
print(f"acierto en prueba: {acierto_test:.3f}")
acierto en entrenamiento: 0.866
acierto en prueba: 0.770¿Qué palabras usa?
Lo mejor de este modelo es que se puede leer. Cada palabra tiene un coeficiente: si es positivo, esa palabra empuja hacia “recomienda”; si es negativo, hacia “no recomienda”. Son las palabras que en el diccionario elegíamos a mano, pero ahora las eligieron los datos.
coeficientes = pd.Series(
    modelo[-1].coef_[0],
    index=modelo[0].get_feature_names_out(),
).sort_values()

extremos = pd.concat([coeficientes.head(10), coeficientes.tail(10)]) # Los más negativos quedan abajo (tail 10) y los más positivos arriba (head 10)

fig, ax = plt.subplots(figsize=(6, 6), dpi=150)
ax.barh(extremos.index, extremos.values, color=[NARANJA if v < 0 else VERDE for v in extremos.values])
ax.axvline(0, color=GRAFITO, linewidth=0.8)
ax.set_xlabel("coeficiente")
ax.set_title("Las palabras que más empujan hacia cada lado")
guardar(fig, "clase11_coeficientes.png")
plt.show()

assert coeficientes["no"] < 0
assert coeficientes["quejar"] > 0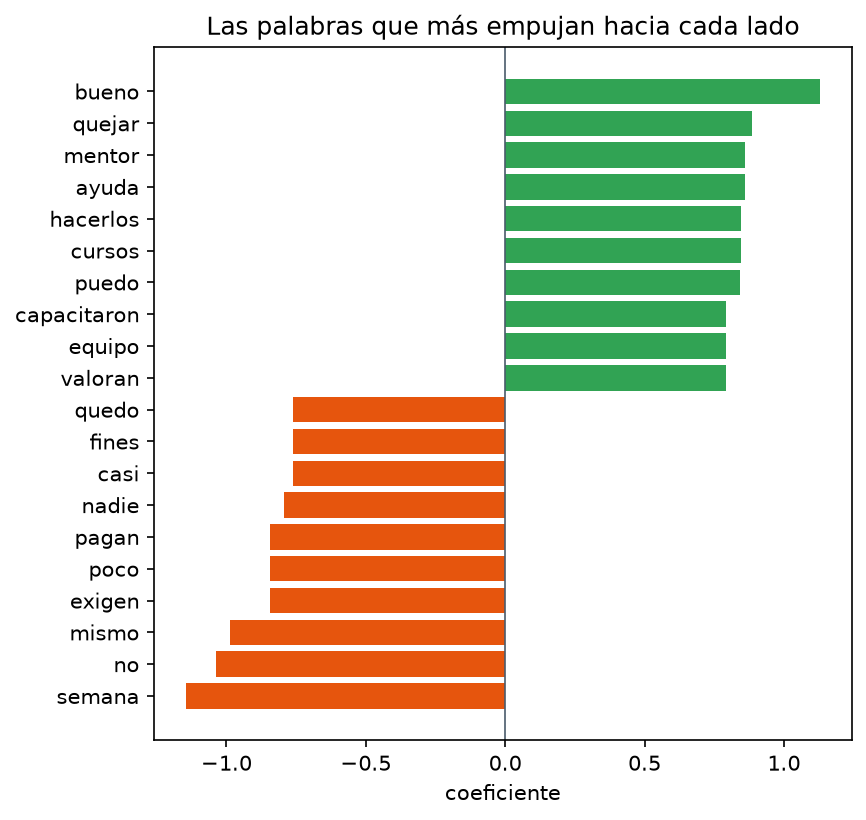
Aparecen palabras que nunca habríamos puesto en un diccionario de sentimiento, como “semana” (de “trabajo los fines de semana”), “mismo” (de “hago siempre lo mismo”) o “mentor”, porque el modelo aprende de este corpus. “No”, que en una lista de stopwords habríamos tirado, es de las más importantes. Y mirá “quejar”: el diccionario la tenía como negativa, y el modelo aprendió que es positiva, porque en Nimbus casi siempre aparece en “no me puedo quejar”.
✏️ Consigna 1: escribí tus propios comentarios
Inventá 3 comentarios que podría haber escrito un empleado de Nimbus y mirá qué probabilidad de recomendar les da el modelo. Buscá al menos uno donde se equivoque. ¿Por qué creés que le erra?
# TODO: escribí tres comentarios
mios = [
    ___,
]
prob_mios = modelo.predict_proba(mios)[:, 1]
pd.DataFrame({"comentario": mios, "prob. de recomendar": prob_mios.round(2)})
✏️ Consigna 2: de a dos palabras
La bolsa de palabras pierde el orden en el que aparecen las palabras, y por eso le cuesta “no me siento valorado”. Una solución parcial es contar también pares de palabras seguidas (se les llama bigramas): “siento valorado”, “no hay”, “buen clima”. En CountVectorizer se pide con el parámetro ngram_range=(1, 2): palabras sueltas y pares.
Armá un modelo nuevo con bigramas, compará su acierto en prueba con el anterior y mirá cuántas columnas tiene ahora la bolsa de palabras.
Pistas:
- es el mismo
make_pipelinede arriba, con un argumento más enCountVectorizer; - el modelo es
LogisticRegression.
modelo_bi = make_pipeline(
    # TODO: palabras sueltas y pares
    CountVectorizer(preprocessor=limpiar, stop_words=STOPWORDS, ngram_range=___),
    # TODO: el modelo
    ___,
)
modelo_bi.fit(X_train, y_train)

print("columnas con palabras sueltas:", len(modelo[0].get_feature_names_out()))
print("columnas con palabras y pares:", len(modelo_bi[0].get_feature_names_out()))
print("acierto en prueba, palabras sueltas:", round(modelo.score(X_test, y_test), 3))
print("acierto en prueba, palabras y pares:", round(modelo_bi.score(X_test, y_test), 3))
Las columnas se multiplican y el acierto en prueba no cambia. Con unos 380 comentarios para entrenar, la mayoría de los pares aparece una o dos veces, y el modelo no tiene suficientes muestras como para aprender qué significan. Los bigramas ayudan cuando hay muchos textos. Con pocos, pueden sumar columnas sin agregar información.
6. Tu caja de herramientas
Todo lo de hoy entra en dos funciones que podés copiar a tu TP. Funcionan con cualquier columna de texto y cualquier etiqueta: respuestas abiertas, entrevistas transcriptas, posteos.
def comparar_palabras(textos, grupos):
    """Las n palabras más frecuentes en cada grupo (sin stopwords)."""
    tabla = {}
    for g in sorted(pd.unique(grupos)):
        frec = palabras_frecuentes(textos[grupos == g])
        tabla[g] = [f"{palabra} ({veces})" for palabra, veces in frec.items()]
    return pd.DataFrame(tabla)


def clasificar_textos(textos, etiquetas, n_palabras=10):
    """Entrena un clasificador de bolsa de palabras y muestra qué palabras usa."""
    X_tr, X_te, y_tr, y_te = train_test_split(
        textos, etiquetas, test_size=0.3, random_state=SEED, stratify=etiquetas
    )
    m = make_pipeline(
        CountVectorizer(preprocessor=limpiar, stop_words=STOPWORDS),
        LogisticRegression(max_iter=1000),
    )
    m.fit(X_tr, y_tr)
    print("acierto en prueba:", round(m.score(X_te, y_te), 3))
    print("acierto de decir siempre la clase más común:", round(y_te.value_counts(normalize=True).max(), 3))
    coef = pd.Series(m[-1].coef_[0], index=m[0].get_feature_names_out()).sort_values()
    print("\nempujan hacia", m.classes_[0], ":", list(coef.index[:n_palabras]))
    print("empujan hacia", m.classes_[1], ":", list(coef.index[-n_palabras:][::-1]))
    return m


comparar_palabras(datos["comentario"], datos["recomienda"])| 0 | 1 | |
|---|---|---|
| 0 | no (192) | no (53) |
| 1 | reuniones (79) | equipo (41) |
| 2 | nada (77) | trabajo (41) |
| 3 | trabajo (43) | nada (32) |
| 4 | siento (40) | flexibilidad (29) |
| 5 | hacer (40) | puedo (29) |
| 6 | equipo (37) | bien (29) |
| 7 | sueldo (35) | sueldo (27) |
| 8 | quedo (33) | feedback (26) |
| 9 | decisiones (33) | lider (25) |
| 10 | nadie (29) | apoya (25) |
| 11 | flexibilidad (26) | da (25) |
La receta, para cualquier corpus
- Juntá los textos en una columna de un DataFrame, con un identificador para poder cruzarlos con el resto de tus datos (
merge). - Mirá los textos. Leé al menos 20 o 30 antes de hacer cualquier cosa.
- Limpiá: minúsculas, tildes, respuestas vacías. Revisá las stopwords antes de sacarlas.
- Contá palabras por grupo (
comparar_palabras). Muchas veces con esto alcanza. - ¿No tenés etiquetas? Un diccionario. Validalo contra alguna variable que no haya usado, como hicimos con la nota.
- ¿Tenés etiquetas (al menos unos cientos de textos)? Un clasificador (
clasificar_textos), comparado siempre contra la clase más común. Y leé los coeficientes. - Leé los errores. Ahí aparece lo que el método no está viendo.
Cierre
Lo que te llevás
- El texto se puede tratar como datos, pero primero hay que mirarlo y limpiarlo.
- Contar palabras por grupo es el primer análisis, y muchas veces alcanza.
- Un diccionario mide sentimiento sin etiquetas, pero no ve negaciones ni ironía. Validalo siempre contra algo que no haya usado.
- La bolsa de palabras convierte cada texto en una fila de números; con eso se puede usar cualquier modelo de la materia.
- Un clasificador elige las palabras desde los datos, y sus coeficientes se pueden leer.
- Ninguno de los dos sabe qué significan las palabras. Eso lo retomamos la clase que viene.
Todo el código de hoy, en pocas líneas
datos["puntaje"] = datos["comentario"].map(puntaje)                       # diccionario
vec = CountVectorizer(preprocessor=limpiar, stop_words=STOPWORDS)         # bolsa de palabras
modelo = make_pipeline(vec, LogisticRegression(max_iter=1000))            # clasificador
modelo.fit(X_train, y_train)
modelo.predict_proba(["un comentario nuevo"])                             # textos nuevos
coeficientes = pd.Series(modelo[-1].coef_[0], index=modelo[0].get_feature_names_out())
Para seguir
- James y otros, capítulo 10, sección 4 (“Document Classification”): bolsa de palabras sobre reseñas de películas.
- La clase que viene: embeddings y LLMs, y cómo usarlos desde Python con una API.